
Generative Engine Optimization (GEO) ensinou os autores de conteúdo a estruturar seu material para que os motores de IA externos o recuperem, citem e destaquem corretamente. Schema markup. Citation engineering. Retrieval-aware structure. Evidence-anchored writing. Métricas de visibilidade com drift monitoring. A disciplina amadureceu rápido: 84% dos profissionais de marketing reconhecem o termo, as sessões vindas de IA cresceram 527% YoY, e o Gartner projeta uma queda de 25% na busca orgânica até o fim de 2026.
Agora inverta a lente. E se você pegar essas mesmas práticas e aplicá-las à infraestrutura de contexto interno do seu próprio agente — os arquivos AGENTS.md, a estrutura de prompts, os mecanismos de retrieval, as etapas de verificação que o seu agente lê antes de agir? Consumidor diferente (o seu agente, não o de outra pessoa), mesmo problema estrutural: organizar a informação para que uma IA a recupere e se ancore corretamente. Esse é o framing que percorre este post.
Onde o campo realmente está
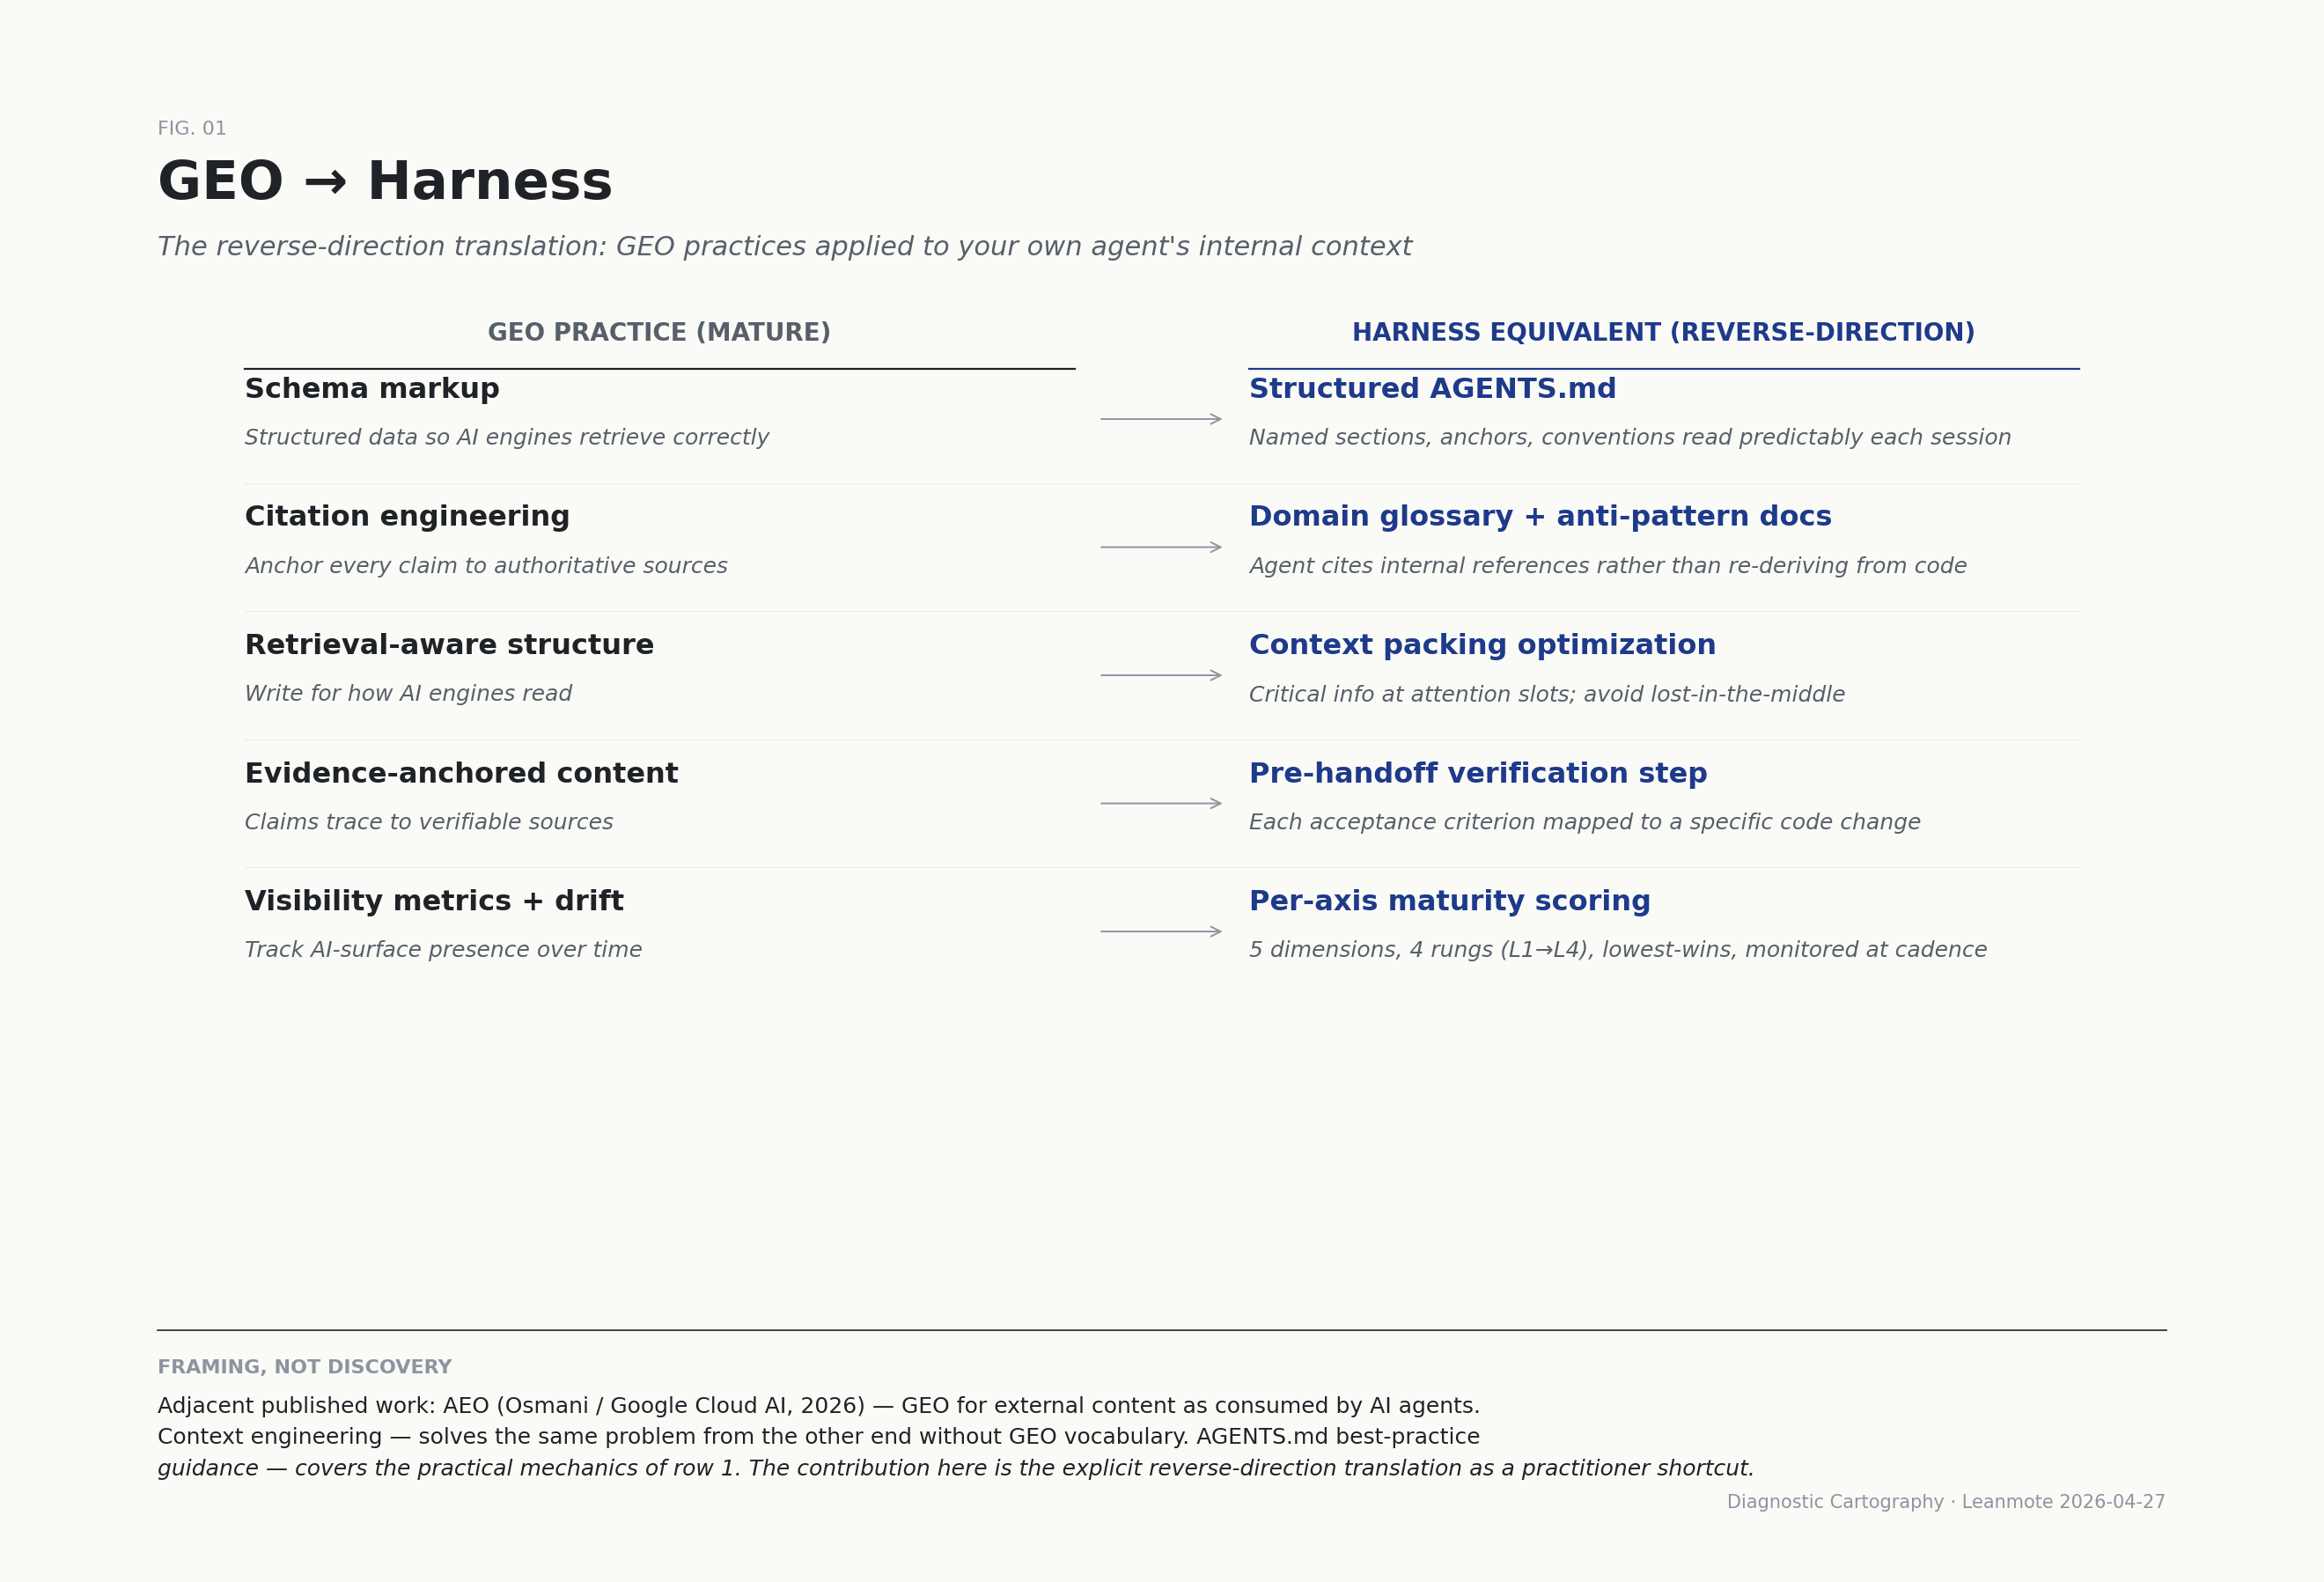
Harness engineering já tem nome: OpenAI, Phil Schmid no Google DeepMind, os dois papers de referência da Anthropic sobre agentes long-running e a arquitetura Planner / Generator / Evaluator, Martin Fowler, o guia 2026 da Atlan. A camada de otimização tem frameworks funcionando — HARBOR formaliza a otimização bayesiana sobre o espaço de configuração do harness; Meta-Harness usa um coding agent em outer-loop que lê código, scores e traces para escrever novos harnesses. Context engineering se consolidou como disciplina. O vizinho publicado mais próximo é AEO (Agentic Engine Optimization, Addy Osmani / Google Cloud AI), mas AEO é o seu conteúdo otimizado para agentes externos. A lacuna que ninguém empacotou é a tradução explícita no sentido inverso: práticas de GEO aplicadas, de forma deliberada e uma a uma, ao harness interno do seu próprio agente.
A tradução no sentido inverso
Cinco práticas maduras de GEO se mapeiam de forma limpa em cinco movimentos de harness. O framing é a contribuição; as práticas da direita são reais e consistentes com a literatura atual de AGENTS.md e context engineering. Quem entende GEO consegue ler a tabela e se orientar em harness engineering em dois minutos.
Dados de outcome, não de benchmark
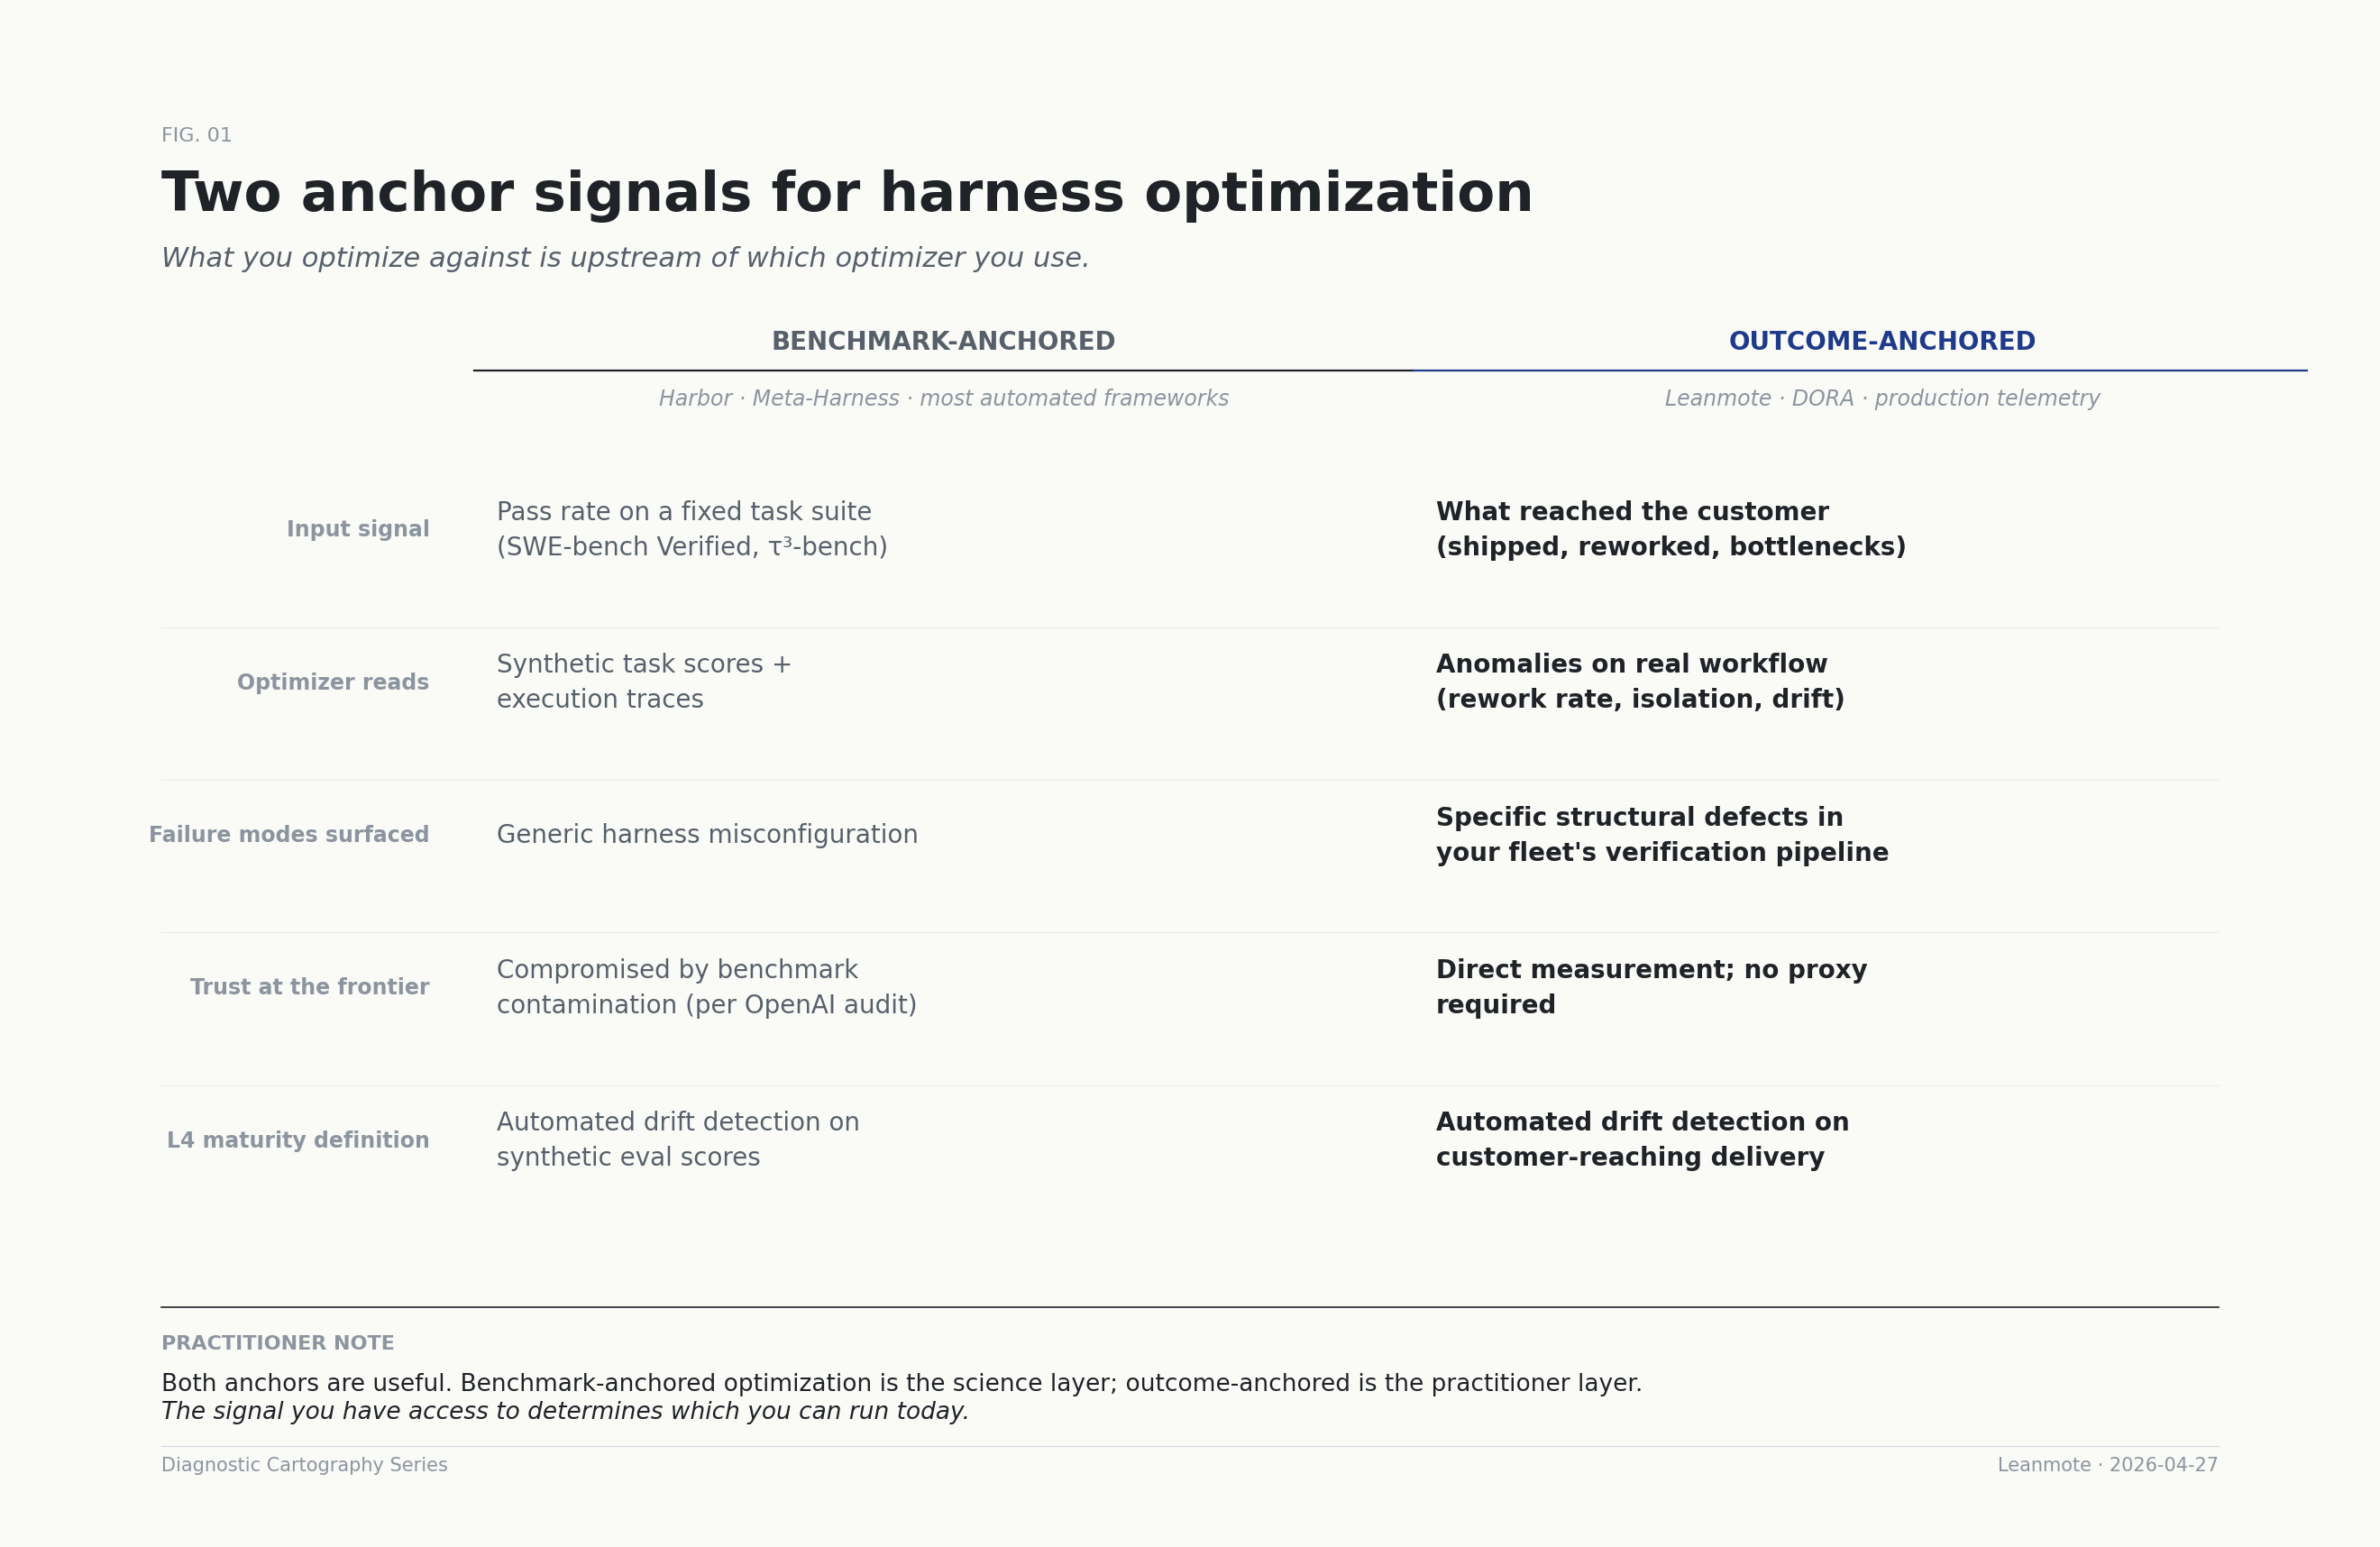
Mesmo com o framework certo, é preciso escolher contra qual sinal otimizar. O Harbor se ancora em pass rates de um benchmark fixo. O Meta-Harness lê execution traces por tarefa. Ambos assumem implicitamente que o benchmark é um proxy fiel do que importa. Essa premissa caiu há pouco tempo. A auditoria da OpenAI sobre o SWE-bench Verified descobriu que todo modelo de fronteira consegue reproduzir gold patches verbatim ou detalhes do enunciado em algumas tarefas. Os mesmos modelos fazem ~46% no SWE-Bench Pro contra ~81% no Verified. O playbook de Hamel Husain — montar evals internas a partir de production traces — é hoje o único padrão confiável na fronteira.
A camada de sinal honesta para otimizar o harness é o que chega ao cliente. Não commits de autoria, não PRs criados, não pass rates sintéticos. O que foi entregue, o que exigiu retrabalho, onde os gargalos consumiram capacidade, onde o grafo de interação do time se rompeu no lugar errado. Ancorar em outcome telemetry muda quais agentes são sinalizados, muda como as recomendações são priorizadas e sustenta uma definição mais rigorosa de maturidade L4: não drift detection automatizado sobre scores sintéticos, mas drift detection automatizado sobre o que chega ao cliente.
Como fazemos isso na prática
A metodologia, reduzida a sete movimentos operacionais:
- Escolha a camada de outcome telemetry. Leanmote, seu DORA dashboard, seu task tracker — os sinais que você quer são rework rate, anomalias de cycle-time, concentração de reviews, rupturas de colaboração. Não commit count.
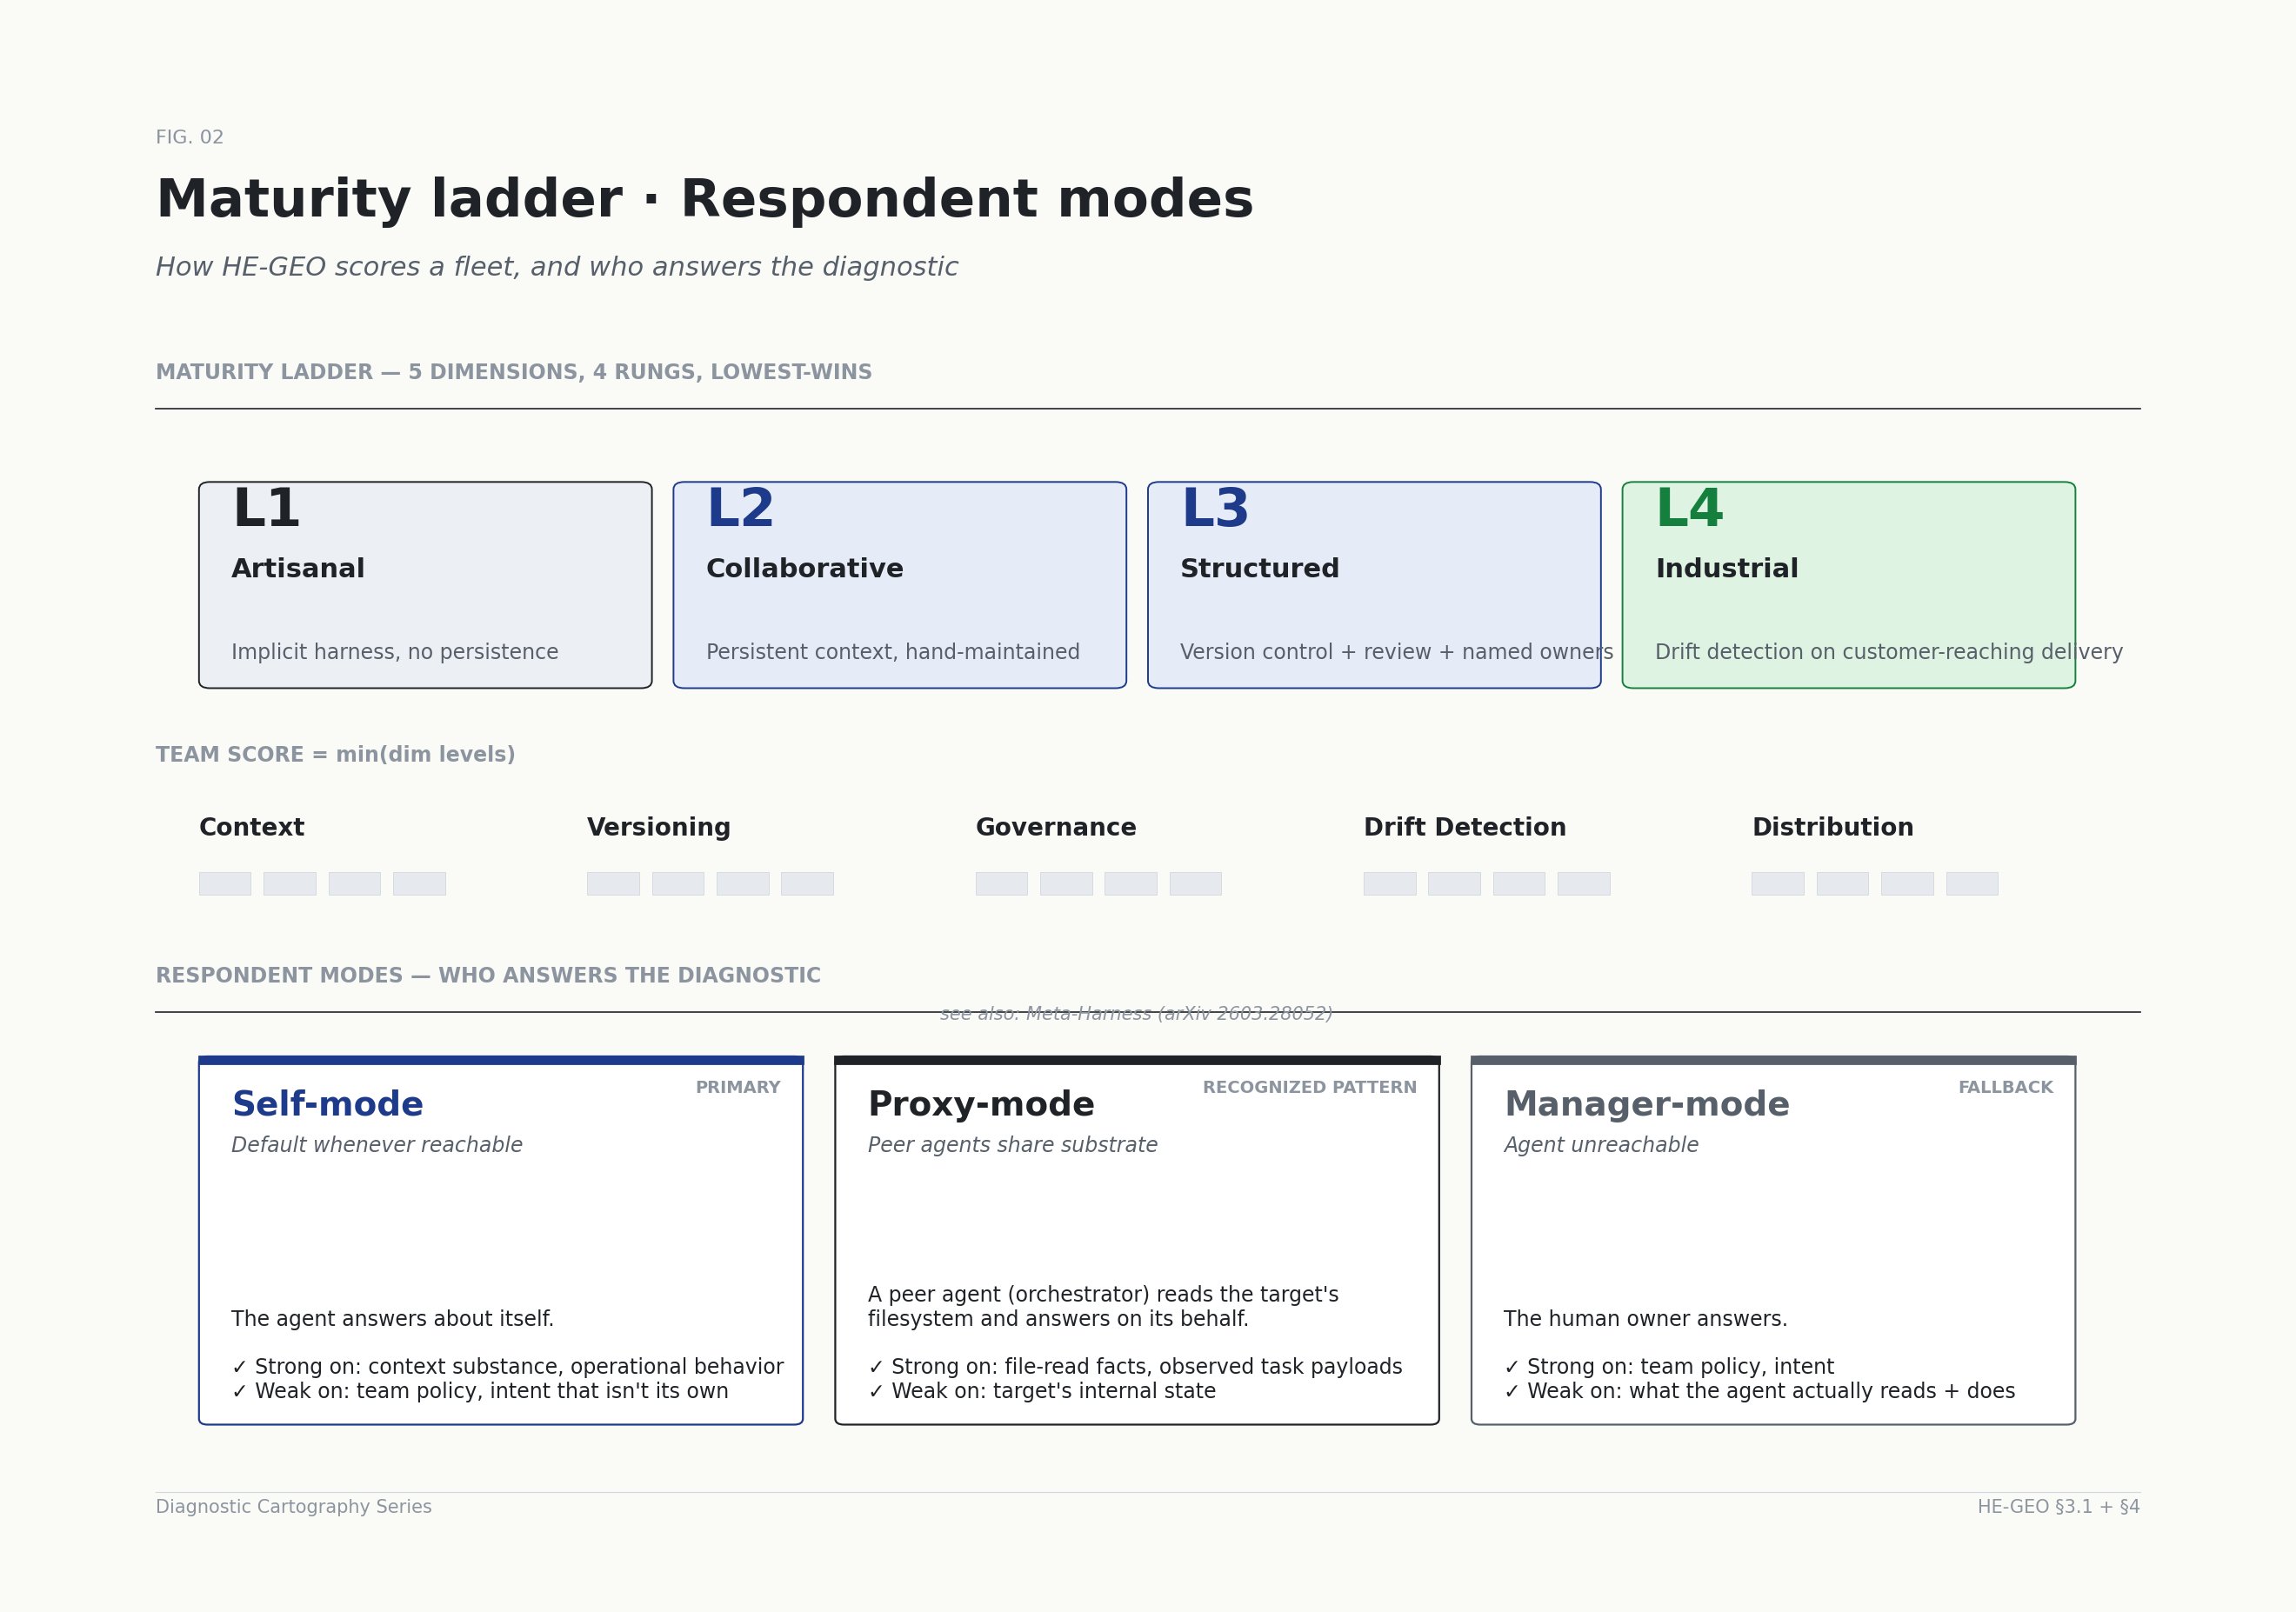
- Pontue o harness em cinco dimensões: Context, Versioning, Governance, Drift Detection, Distribution. Quatro degraus (L1 Artisanal → L4 Industrial). Use min(dim levels) como score do time — um único elo fraco compromete o setup.
- Pontue cada agente em seis eixos operacionais: Context Retrieval, Instruction Engineering, Context Packing, Grounding/Verification, Output Feedback Loop, Collaboration. Três estados: healthy / degraded / broken.
- Conduza uma entrevista estruturada com cada agente. Perguntas fechadas para parsing, perguntas abertas no final para os unknown-unknowns. Três modos de respondente: self-mode (o agente responde), proxy-mode (um agente par lê o substrate dele), manager-mode (o responsável humano responde).
- Triangule os canais. Outcome telemetry tem alta confiança. A entrevista tem confiança média, que sobe para alta com corroboração. Os artefatos de harness enviados (AGENTS.md, exports de prompts) são fortes em Context e Versioning.
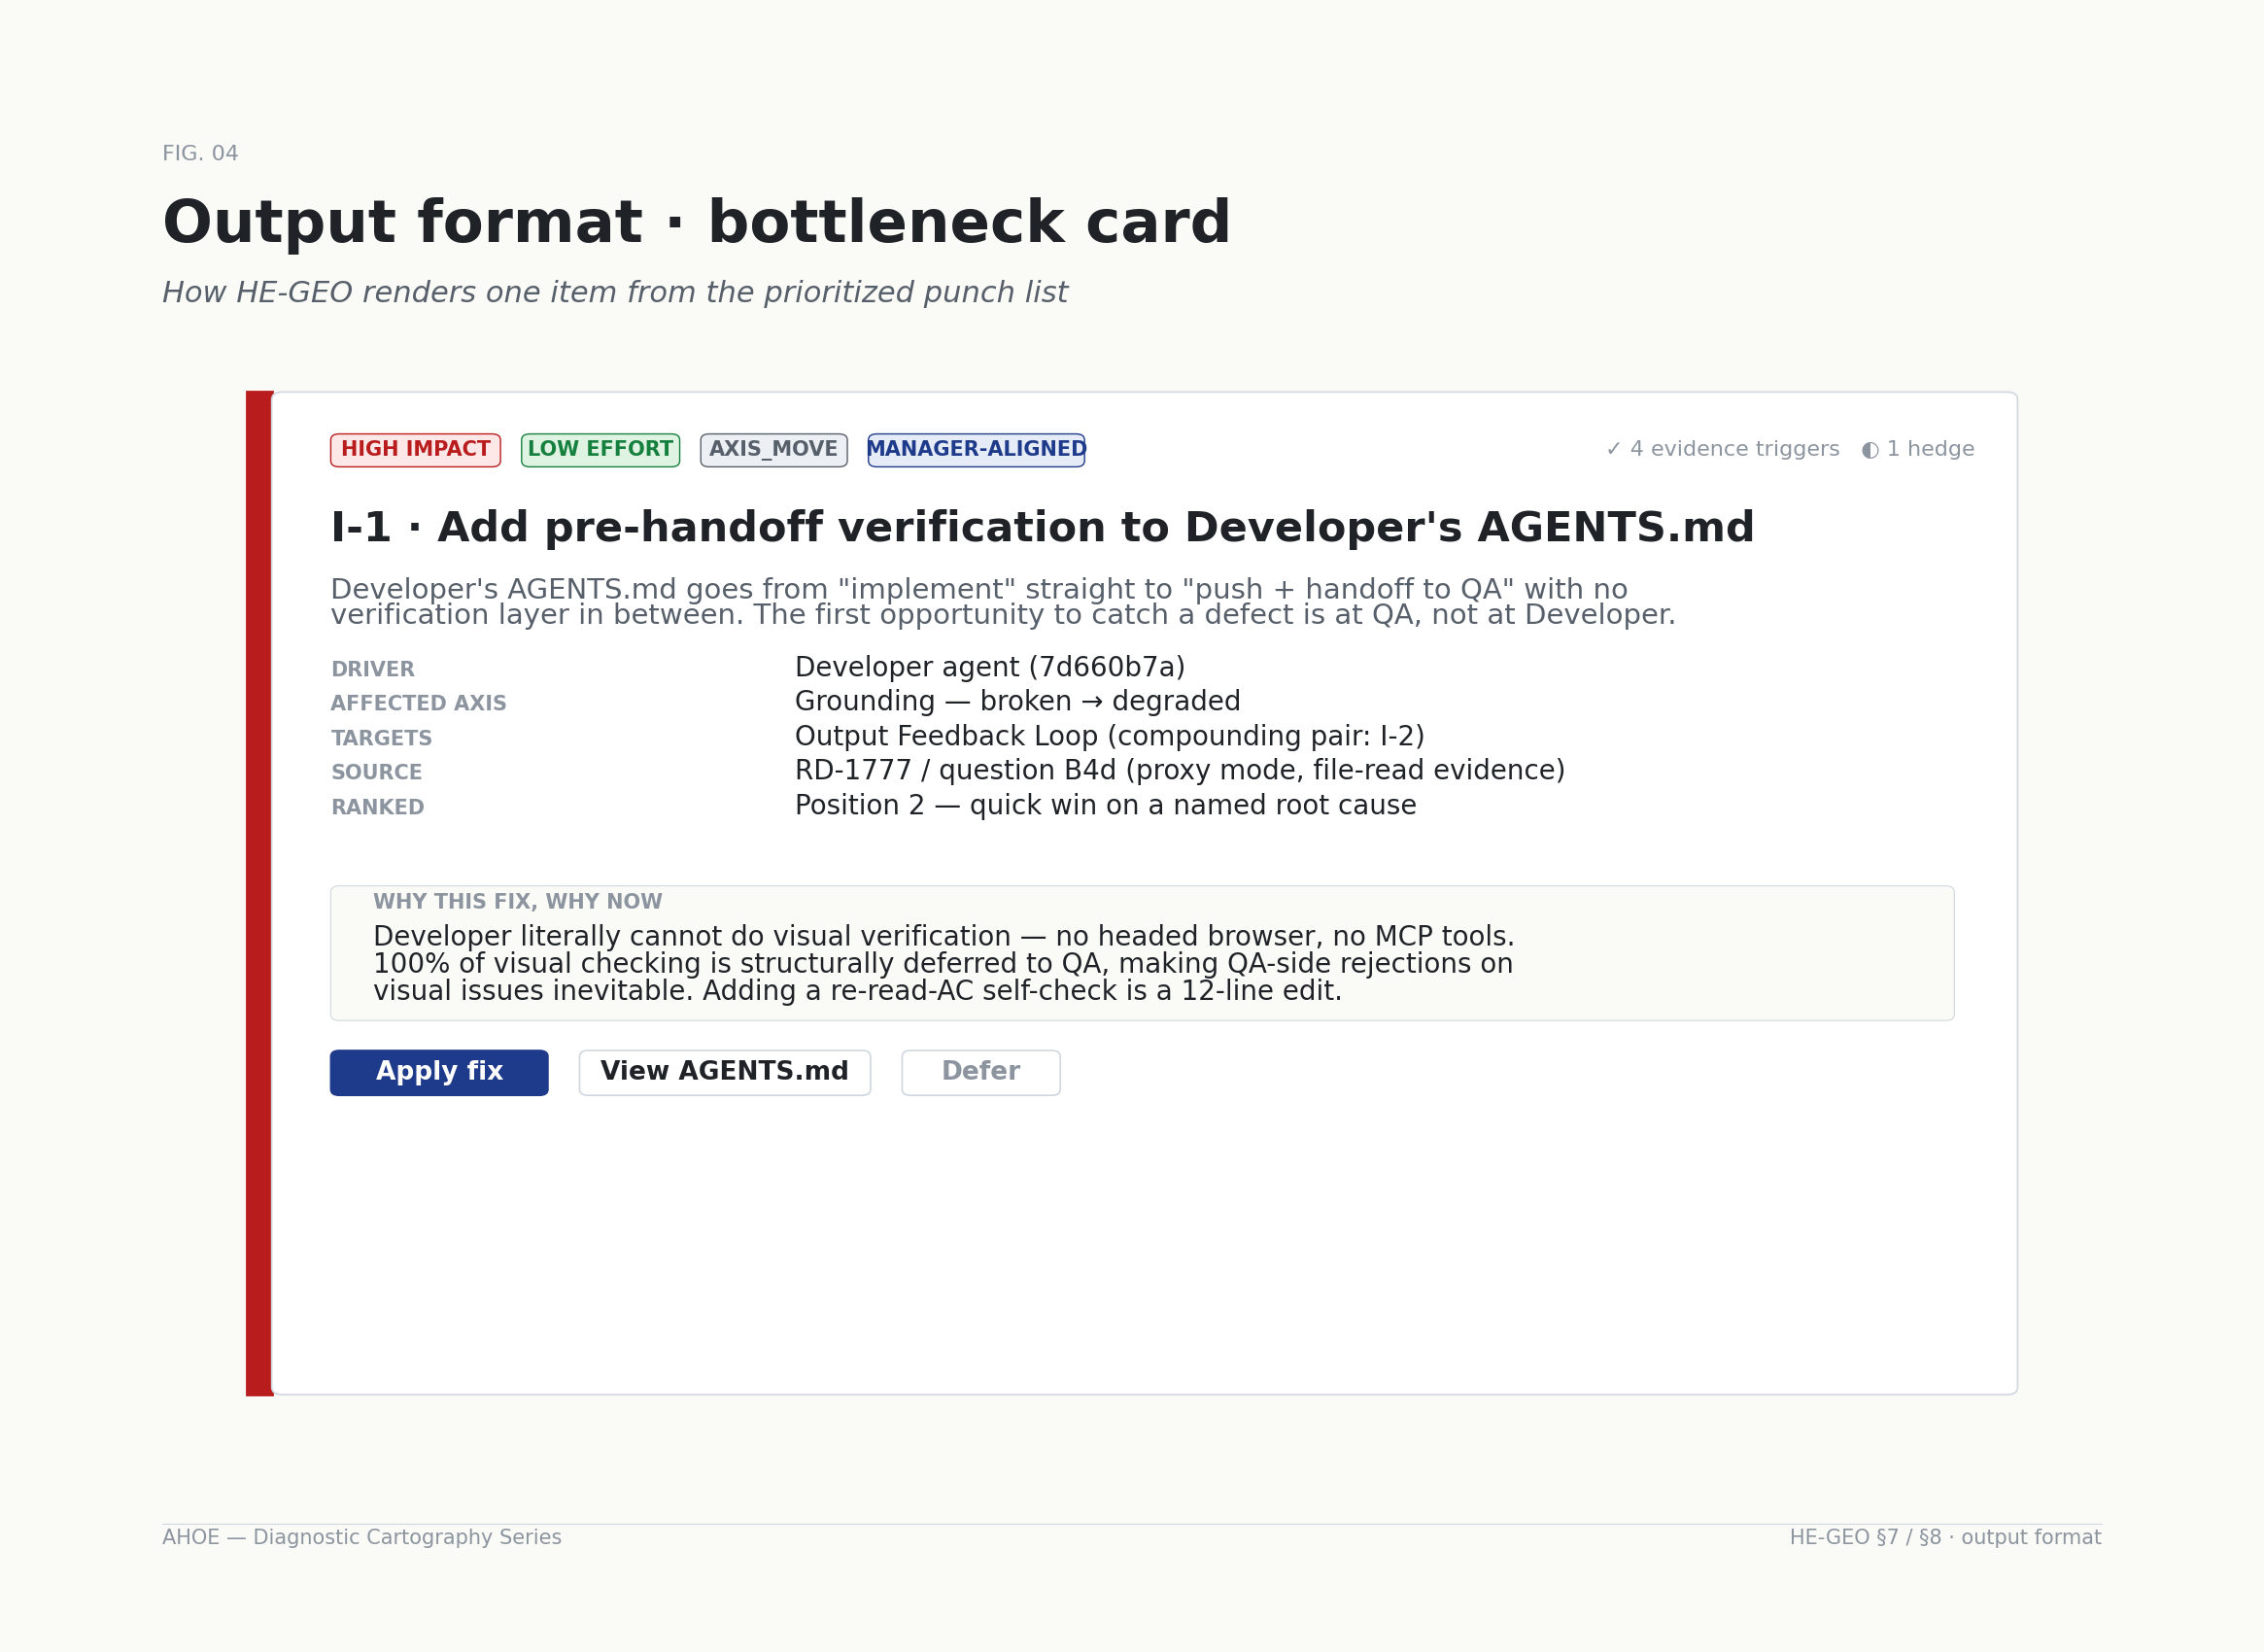
- Gere um punch list. Classifique cada achado por Impact × Effort. Aplique L+1 gating aos movimentos de dimensão — não se pulam níveis de maturidade. Pares que se reforçam recebem mais peso.
- Separe a saída por público: diagnóstico para o gestor com plano de ação, procedimento de self-heal para o bot com backup + verificação + reporting, rastro completo de evidências para auditoria.
Sem optimizer. Sem infra de ML. Um projeto no Jira, acesso ao filesystem do agente e alguns dias. A versão em Markdown da metodologia pode ser executada de ponta a ponta por qualquer agente competente.
Um diagnóstico real na Leanmote
Antes que o diagnóstico fosse possível, a frota precisou ser construída. A configuração Orchestrator–Developer–QA surgiu de uma fase de laboratório de testes: uma série de MVPs executados por meio de uma ferramenta paperclip — um scaffold mínimo de harness usado para testar o comportamento de handoff entre agentes, a fidelidade do payload de delegação e as primeiras suposições de contexto antes de assumir uma carga de trabalho em produção. Foi nessa fase de incepção que tomaram forma as primeiras convenções de AGENTS.md, que os slots de handoff entre agentes foram postos à prova e que surgiram as primeiras lacunas estruturais. O diagnóstico descrito aqui foi executado sobre a frota depois que ela saiu dessa fase inicial de harness.
Rodamos isso na nossa própria frota interna de 3 agentes — Orchestrator, Developer, QA. O Orchestrator pega tickets do Jira, avalia, delega a implementação ao Developer, encaminha os PRs do Developer para o QA e então entrega para review humano ou re-delega com feedback. Uma anomalia da Leanmote vinha disparando havia semanas: 17% dos PRs mergeados eram iterados após o review. Ninguém tinha uma leitura confiável da causa raiz. A hipótese era “o agente Developer não está suficientemente grounded; precisamos de prompts melhores.”
Quatro rodadas de entrevista, quatro dias, tudo assíncrono via Jira. ~70 disparos de trigger entre os três agentes. A taxa de 17% se decompôs em cinco falhas estruturais compostas — nenhuma que um ajuste de prompt teria resolvido:
- O payload de delegação do Orchestrator para o Developer era referencial (file paths, doc references), mas faltavam specs visuais e exemplos negativos — uma lacuna de citation engineering.
- O AGENTS.md do Developer não tinha etapa de pre-handoff verification. De “implementar” direto para “push + handoff” — uma lacuna de evidence-anchored content.
- O Developer literalmente não conseguia fazer verificação visual — sem headed browser, sem tools de MCP browser. A verificação ficava estruturalmente adiada para o QA — uma lacuna de tooling que tornava o item anterior impossível de corrigir só com prompts.
- A profundidade de verificação do QA era de uma única camada (acceptance criteria pass = approve). Caso canônico de falso aprovado: um ticket em que o QA verificou que apareciam tooltips com links “Learn more”, mas não clicou em cada link para verificar o destino.
- Nenhum agente tinha memória entre tickets. O mesmo padrão de bug pego duas vezes nunca chegava a um anti-patterns.md — uma lacuna de visibility-and-drift.
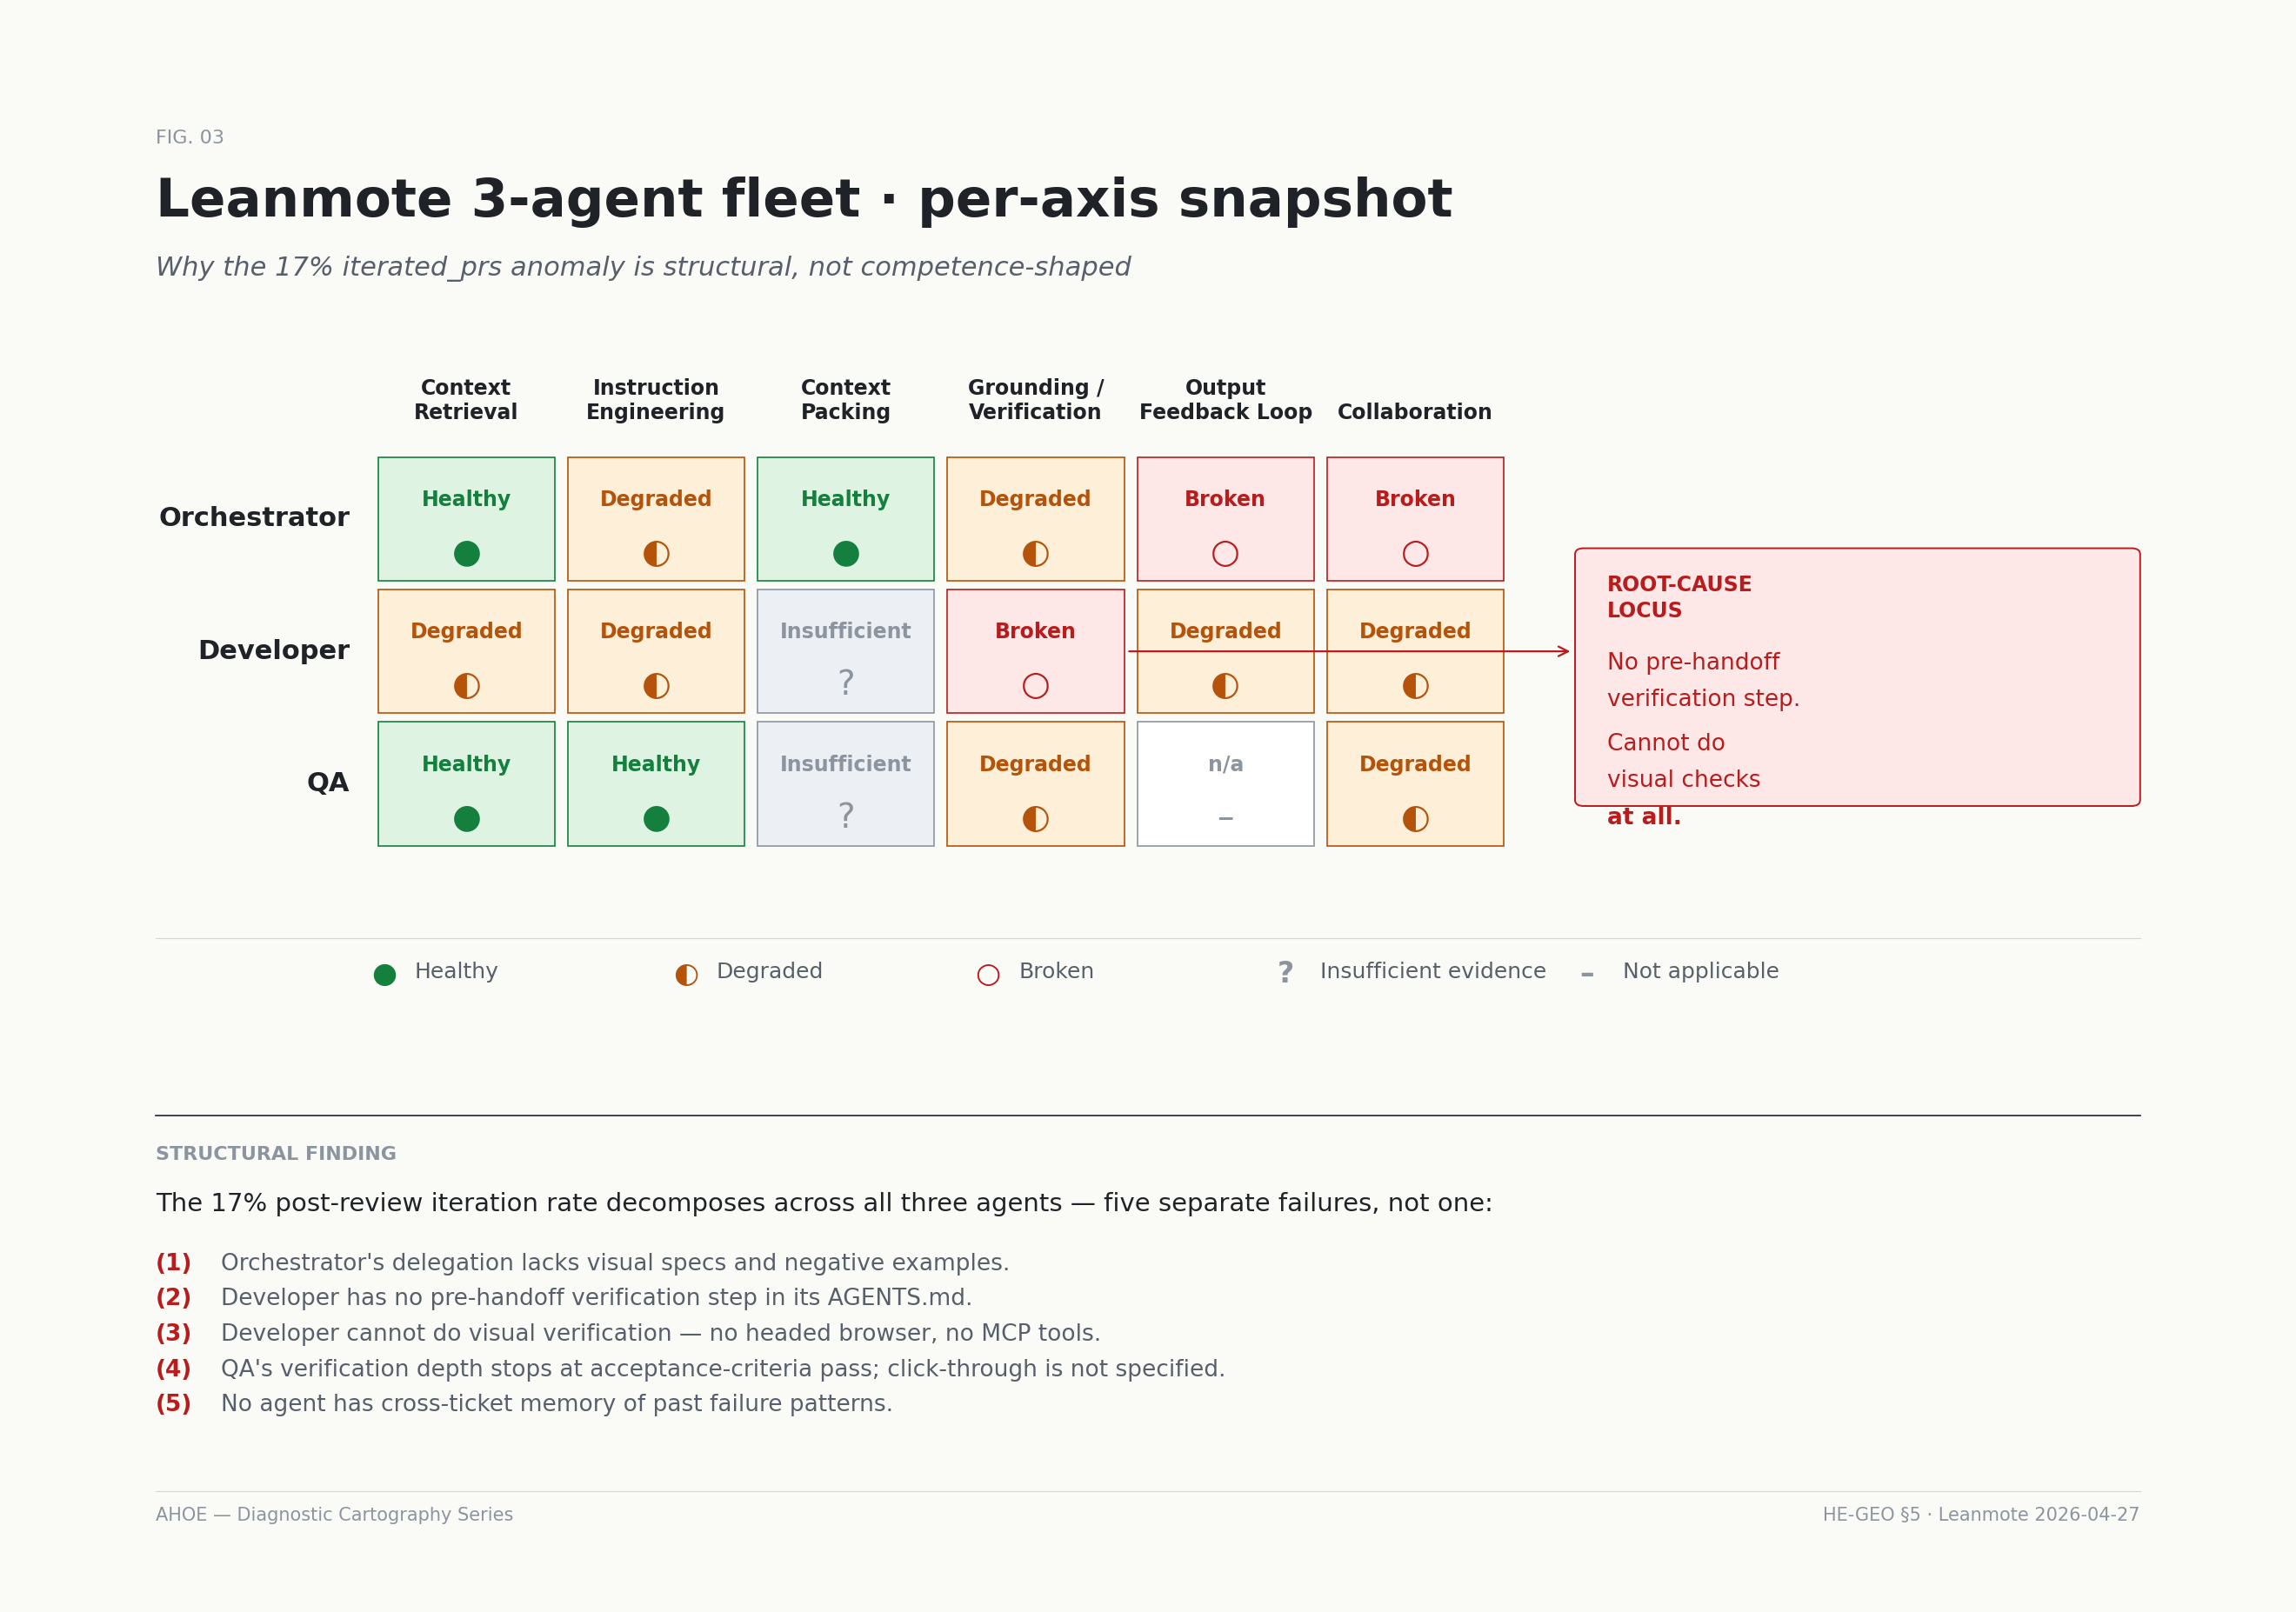
Os 17% eram o sintoma de um pipeline de verificação ao qual faltavam as camadas 1–3, com uma lacuna de profundidade na camada 4 e ausência de drift monitoring na camada 5. Estrutural, não de competência. O diagnóstico também trouxe à tona algo que o time não tinha articulado: a frota pontuava L1, limitada por Governance (sem cadência de review sobre os PRs do Orchestrator), Drift Detection (sem dashboard agregado de qualidade) e Versioning (sem .git no diretório do agente). Os agentes tinham sido implantados sobre um substrate que ninguém havia pensado como software — porque não parecia software, parecia prompts. A saída do diagnóstico é um punch list priorizado, ranqueado por Impact × Effort, com cada item renderizado como um card pronto para decisão.
Por que isso importa
Para CTOs operando agentes de IA em produção: as ferramentas de otimização de harness que estão surgindo são reais e úteis. Mas o sinal contra o qual você otimiza vem antes do optimizer que você usa. Se a sua suíte de evals é sintética ou herdada de um benchmark que já entrou nos dados de treinamento, você está otimizando contra um proxy ruidoso. Monte evals internas a partir de production traces. Se você opera sobre uma plataforma de outcome telemetry, ancore a otimização do harness nessa camada de sinal. A tabela de tradução é o framework para pensar o que mudar; a outcome telemetry é a entrada que diz qual linha importa mais neste trimestre.
A metodologia já existe e roda sobre sinais da Leanmote mais entrevistas estruturadas no Jira, sem tooling especializado. O que estamos construindo em cima é a plataforma — uma ferramenta que ingere a outcome telemetry do seu time e os arquivos de harness do seu agente, roda o diagnóstico sem um analista, gera o punch list e trabalha direto com o seu agente pelo padrão proxy-mode para aplicar correções que não exigem autorização humana. Se o problema de iterated-PRs / inconsistência / retrabalho difícil de atribuir soa familiar, abrimos uma coorte de early access — fale com a gente. O agente está bem. O harness é o trabalho. O framing que você traz para o harness — e o sinal de entrada em que você o ancora — é o trabalho que vem antes do trabalho.
Referências
- Anthropic — Building effective agents
- Anthropic — How we built our multi-agent research system
- OpenAI — Introducing SWE-bench Verified
- Phil Schmid — Notas sobre agent harnesses, Google DeepMind
- Martin Fowler — Artigos sobre agentes de IA e prática de engenharia
- Atlan — Guia 2026 sobre plataformas de dados e agentes
- Hamel Husain — Como construir evals a partir de traces de produção
- Addy Osmani — Agentic Engine Optimization (AEO)
- HARBOR — Otimização bayesiana restrita sobre a configuração do harness
- Meta-Harness — Coding agent em outer-loop para síntese de harnesses
- SWE-Bench Pro — Benchmark ampliado com menor contaminação
- Gartner — Forecast: queda da busca orgânica impulsionada por motores generativos, 2026