Generative Engine Optimization (GEO) le enseñó a los autores de contenido cómo estructurar su material para que los motores de IA externos lo recuperen, lo citen y lo eleven correctamente. Schema markup. Citation engineering. Retrieval-aware structure. Evidence-anchored writing. Métricas de visibilidad con drift monitoring. La disciplina maduró rápido: el 84% de los marketers reconoce el término, las sesiones referidas por IA crecieron 527% YoY, y Gartner proyecta una caída del 25% en búsqueda orgánica para fines de 2026.
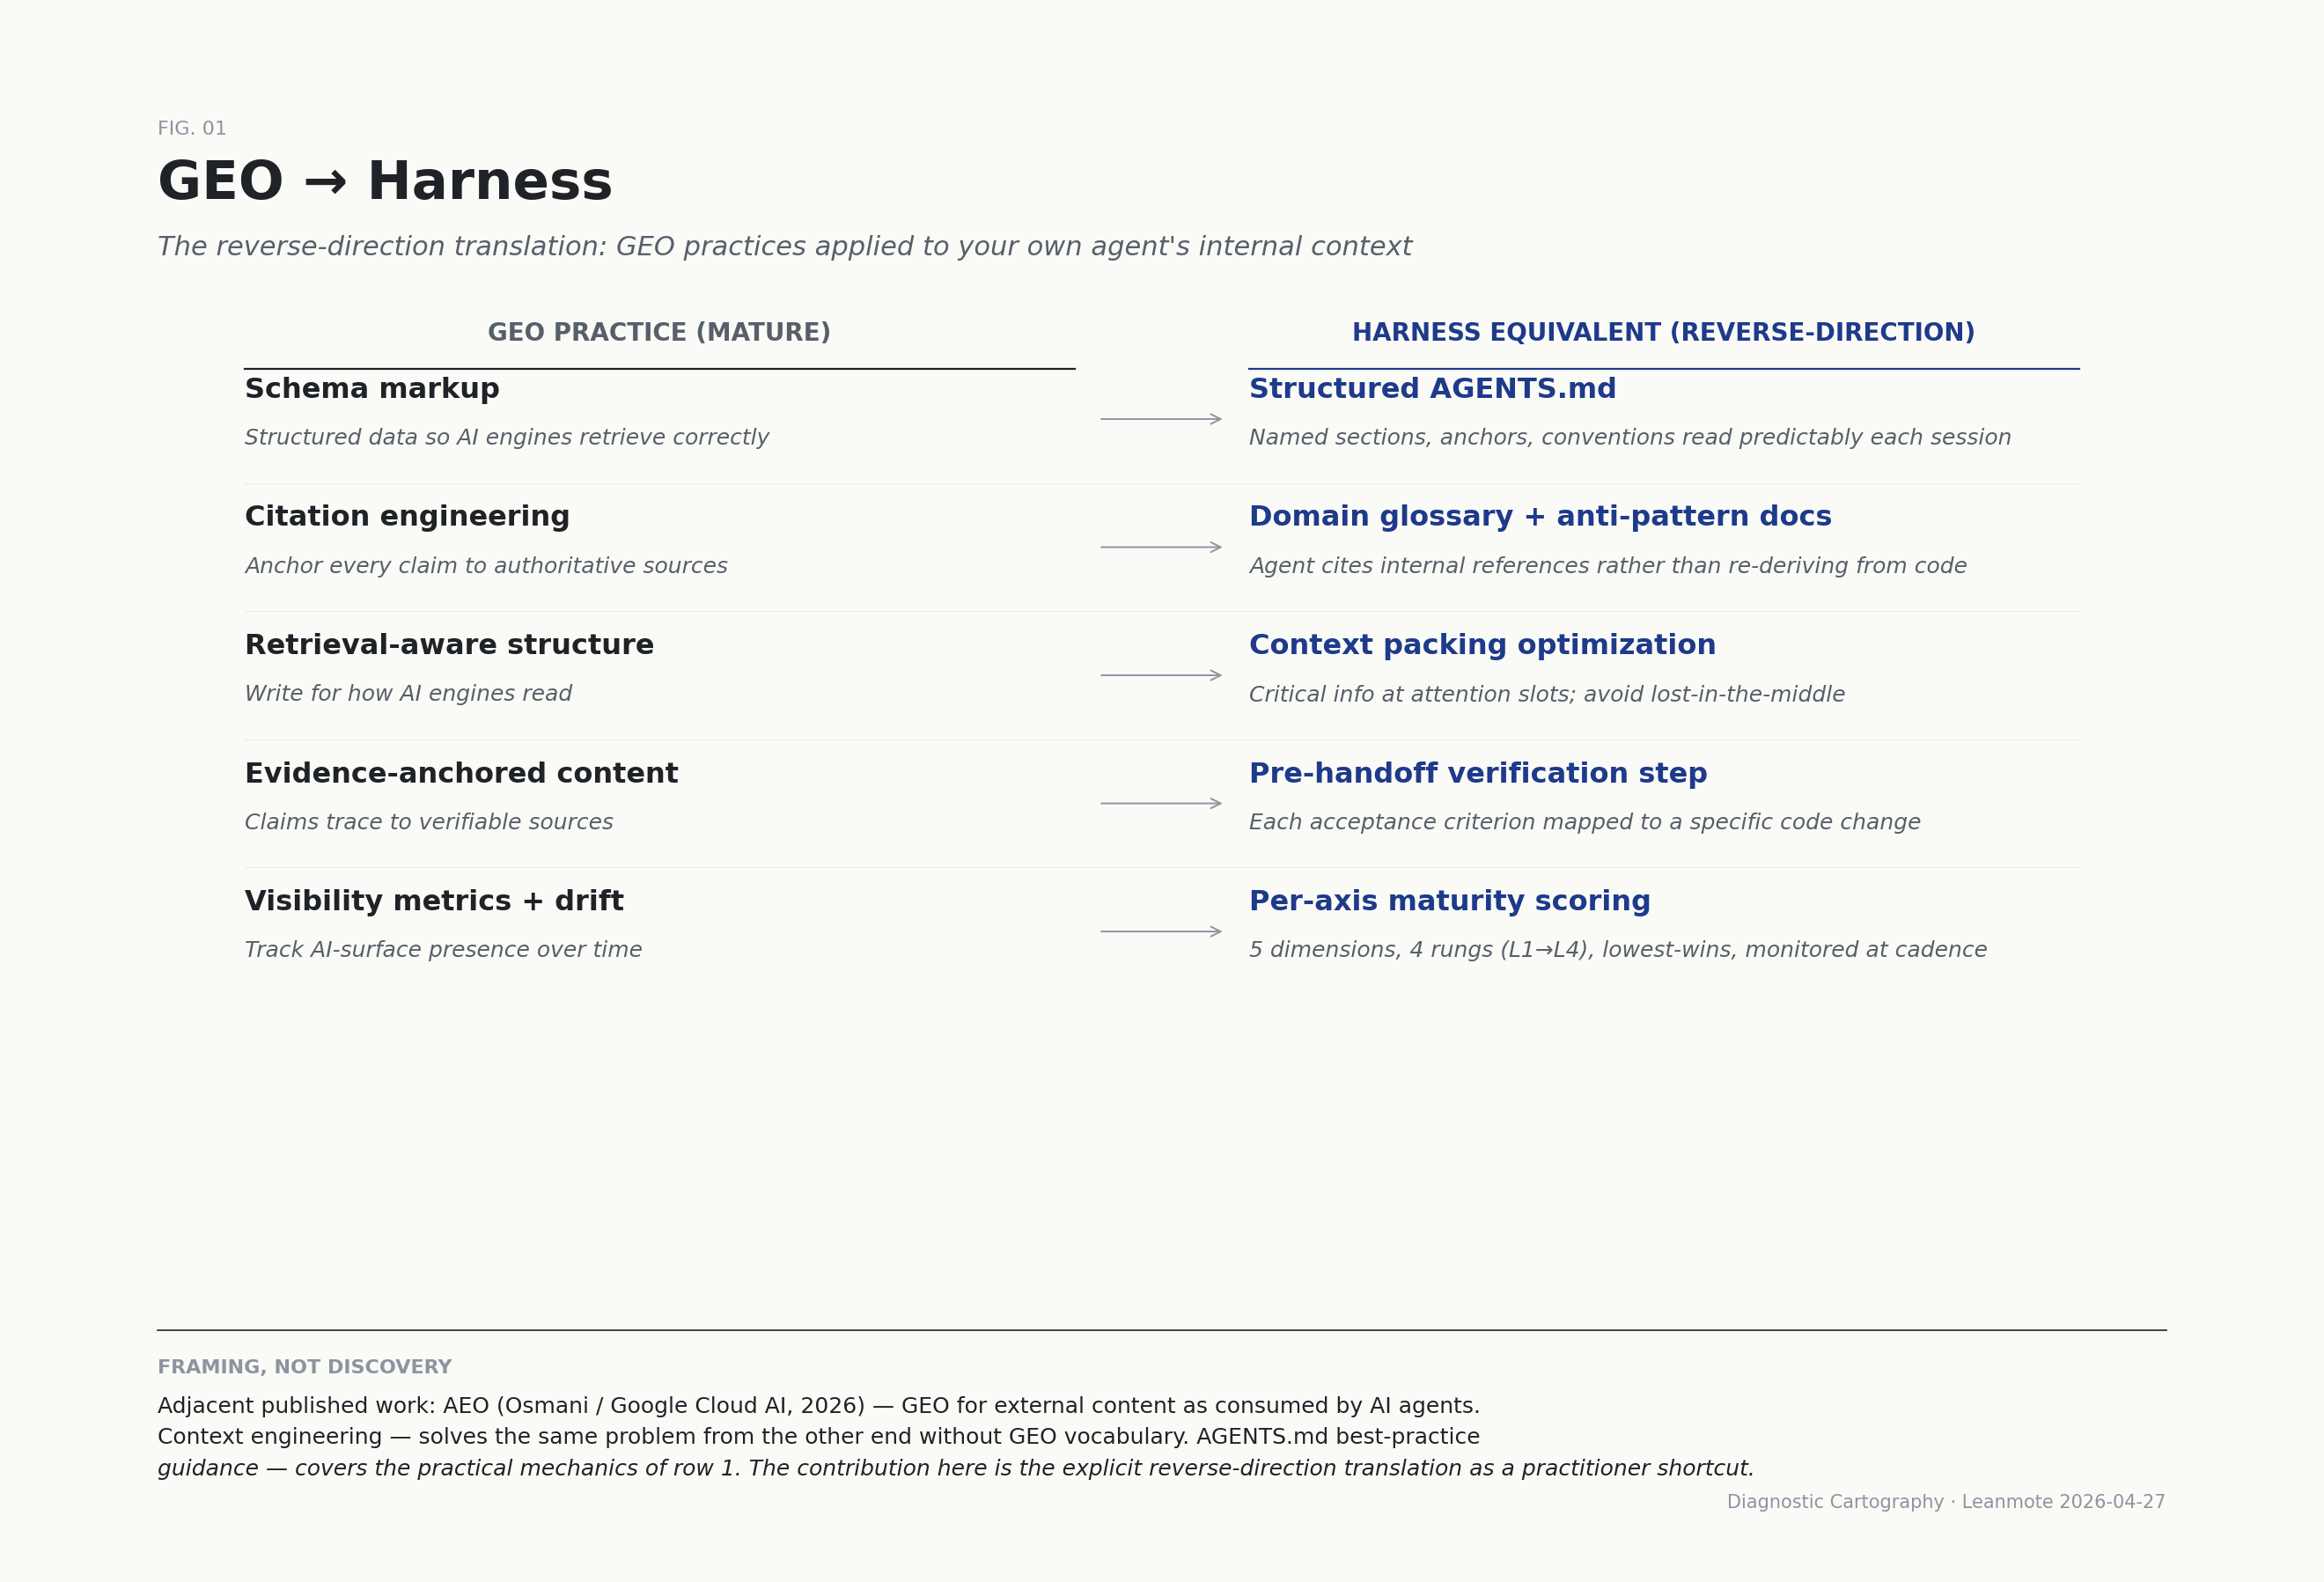
Ahora invertí el lente. ¿Qué pasa si tomás esas mismas prácticas y las aplicás a la infraestructura de contexto interno de tu propio agente — los archivos AGENTS.md, la estructura de prompts, los mecanismos de retrieval, los pasos de verificación que tu propio agente lee antes de actuar? Distinto consumidor (tu agente, no el de otro), mismo problema estructural: organizar la información para que una IA recupere y se ancle correctamente. Ese es el framing que recorre este post.
Dónde está realmente el campo
Harness engineering ya tiene nombre: OpenAI, Phil Schmid en Google DeepMind, los dos papers de referencia de Anthropic sobre agentes long-running y la arquitectura Planner / Generator / Evaluator, Martin Fowler, la guía 2026 de Atlan. La capa de optimización tiene frameworks funcionando — HARBOR formaliza optimización Bayesiana sobre el espacio de configuración del harness; Meta-Harness usa un coding agent en outer-loop que lee código, scores y traces para escribir nuevos harnesses. Context engineering se cristalizó como disciplina. El vecino publicado más cercano es AEO (Agentic Engine Optimization, Addy Osmani / Google Cloud AI), pero AEO es tu contenido optimizado para agentes externos. El hueco que nadie empaquetó es la traducción explícita en sentido inverso: prácticas de GEO aplicadas, deliberada y uno-a-uno, al harness interno de tu propio agente.
La traducción en sentido inverso
Cinco prácticas maduras de GEO mapean limpiamente a cinco movimientos de harness. El framing es la contribución; las prácticas de la derecha son reales y consistentes con la literatura actual de AGENTS.md y context engineering. Quien entiende GEO puede leer la tabla y orientarse en harness engineering en dos minutos.
Datos de outcome, no de benchmark
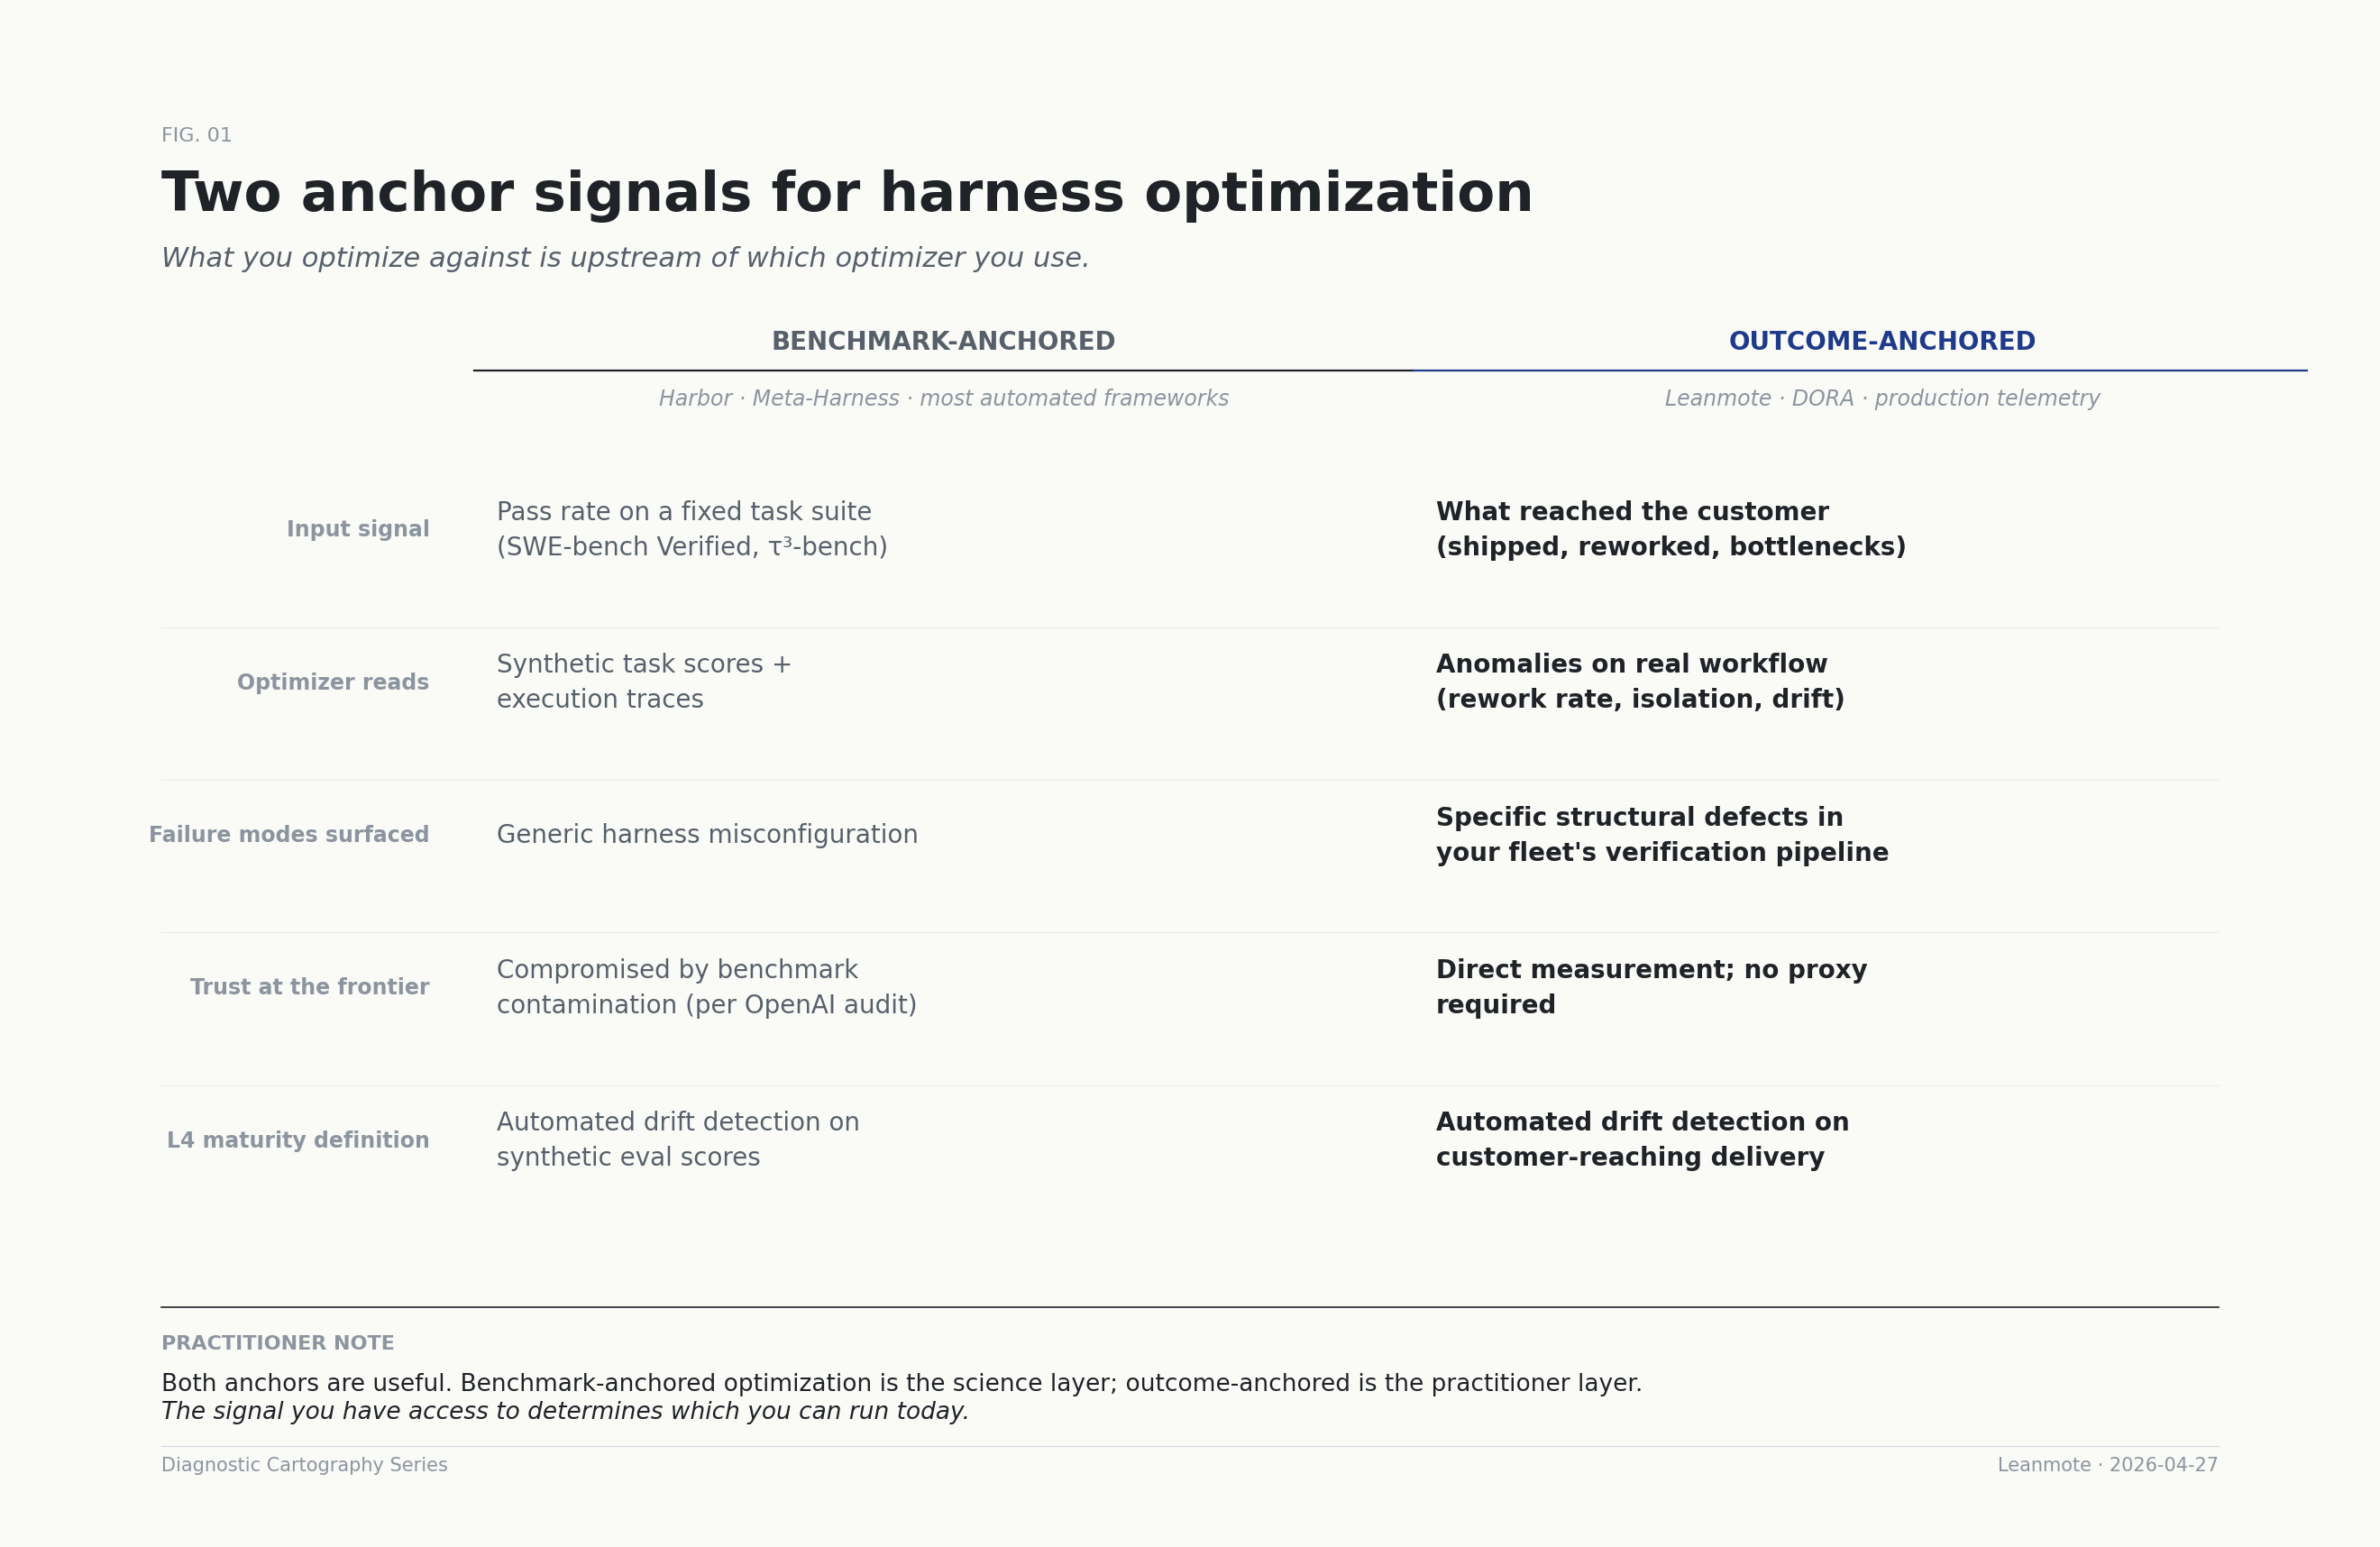
Aún con el framework correcto, hay que elegir contra qué señal optimizar. Harbor ancla en pass rates de un benchmark fijo. Meta-Harness lee execution traces por tarea. Ambos asumen implícitamente que el benchmark es un proxy fiel de lo que importa. Esa asunción se rompió hace poco. El audit de OpenAI sobre SWE-bench Verified encontró que todo modelo de frontera puede reproducir gold patches verbatim o detalles del enunciado en algunas tareas. Los mismos modelos sacan ~46% en SWE-Bench Pro versus ~81% en Verified. El playbook de Hamel Husain — armar evals internas a partir de production traces — es hoy el único patrón confiable en la frontera.
La capa de señal honesta para optimizar el harness es lo que llega al cliente. No commits autorados, no PRs creados, no pass rates sintéticos. Qué se entregó, qué requirió retrabajo, dónde los cuellos de botella se comieron capacidad, dónde el grafo de interacción del equipo se cortó por el lado equivocado. Anclar en outcome telemetry cambia qué agentes se marcan, cambia cómo se priorizan las recomendaciones, y ancla una definición más estricta de madurez L4: no drift detection automatizado sobre scores sintéticos, sino drift detection automatizado sobre lo que llega al cliente.
Cómo lo corremos en la práctica
La metodología, reducida a siete movimientos operativos:
- Elegí la capa de outcome telemetry. Leanmote, tu DORA dashboard, tu task tracker — las señales que querés son rework rate, anomalías de cycle-time, concentración de reviews, quiebres de colaboración. No commit count.
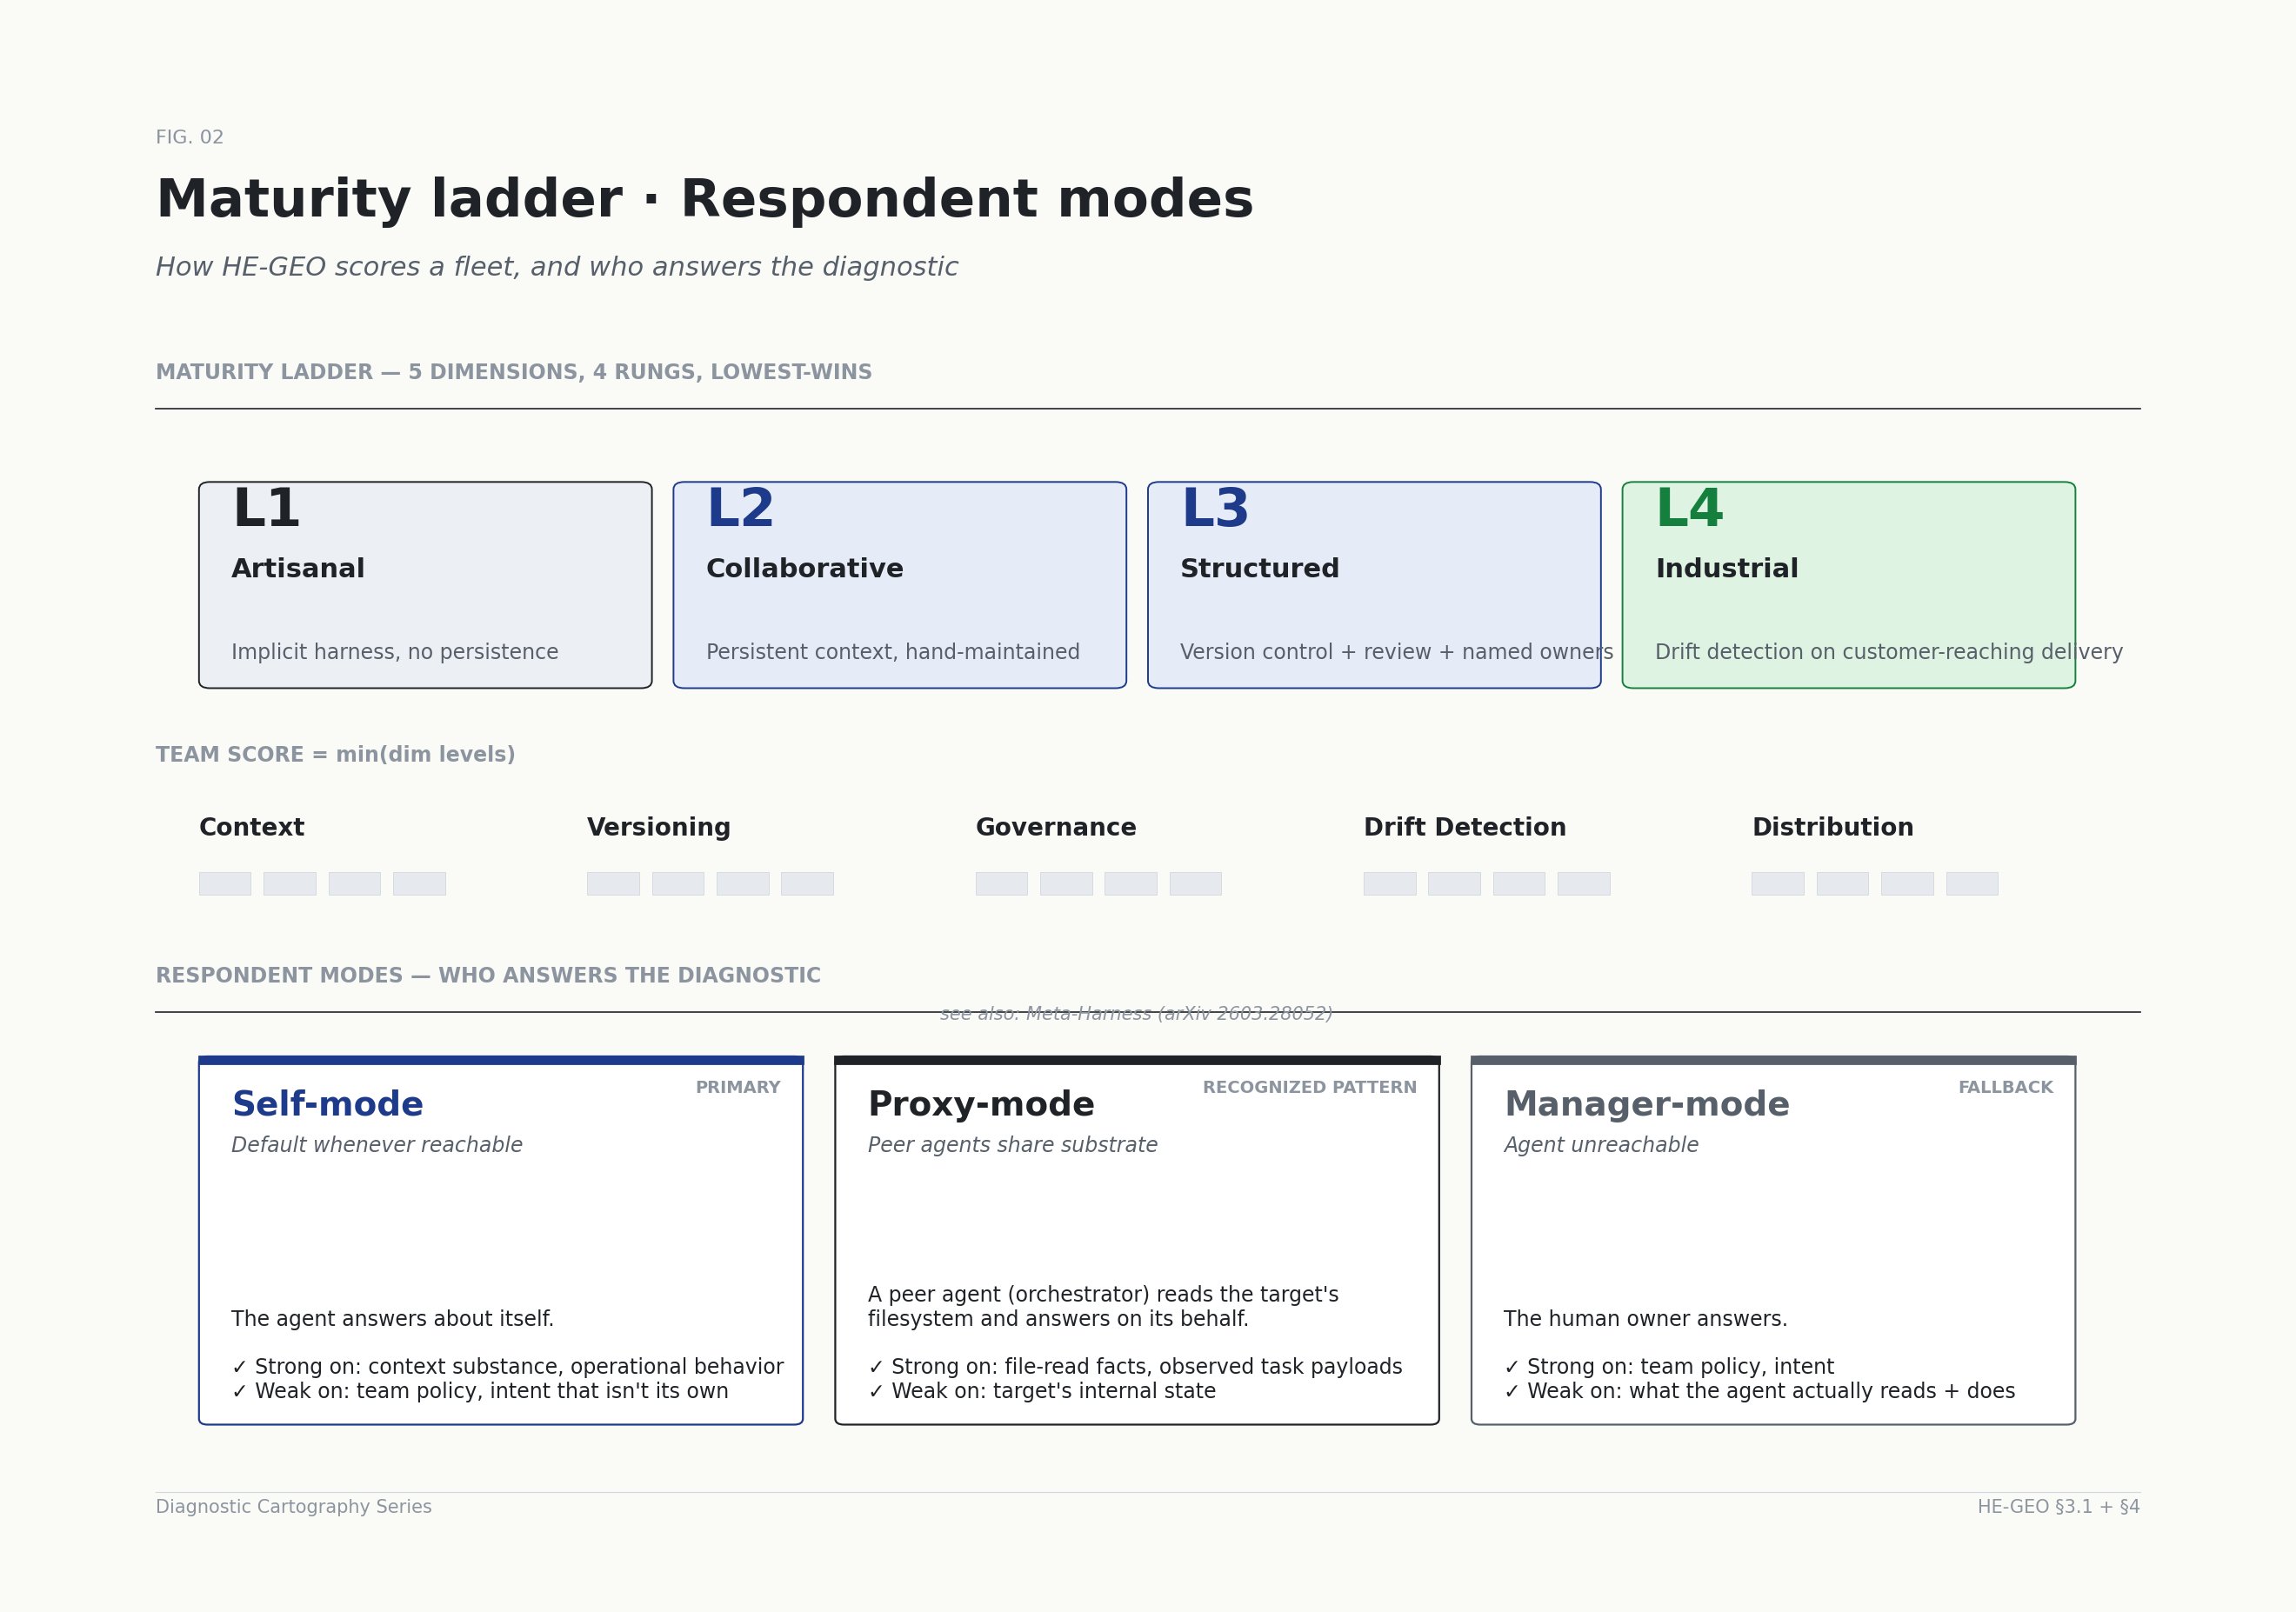
- Puntuá el harness en cinco dimensiones: Context, Versioning, Governance, Drift Detection, Distribution. Cuatro escalones (L1 Artisanal → L4 Industrial). Tomá min(dim levels) como score del equipo — un solo eslabón débil corta el setup.
- Puntuá cada agente en seis ejes operativos: Context Retrieval, Instruction Engineering, Context Packing, Grounding/Verification, Output Feedback Loop, Collaboration. Tres estados: healthy / degraded / broken.
- Corré una entrevista estructurada contra cada agente. Preguntas de stem cerrado para parsing, preguntas de cola abierta para unknown-unknowns. Tres modos de respondedor: self-mode (responde el agente), proxy-mode (un agente par lee su substrate), manager-mode (responde el dueño humano).
- Triangulá los canales. Outcome telemetry es de alta confianza. La entrevista es media, sube a alta con corroboración. Los artefactos de harness subidos (AGENTS.md, exports de prompts) son fuertes en Context y Versioning.
- Generá un punch list. Etiquetá cada hallazgo Impact × Effort. Aplicá L+1 gating a movimientos de dimensión — no se saltean niveles de madurez. Pares que componen reciben más peso.
- Separá la salida por audiencia: diagnóstico para manager con plan de acción, procedimiento de self-heal para el bot con backup + verificación + reporting, traza completa de evidencia para auditoría.
Sin optimizer. Sin infra de ML. Un proyecto de Jira, acceso al filesystem del agente y unos días. La forma Markdown de la metodología puede ser ejecutada de punta a punta por cualquier agente competente.
Un diagnóstico real en Leanmote
Antes de que el diagnóstico fuera posible, la flota tuvo que construirse. La configuración Orchestrator–Developer–QA emergió de una fase de laboratorio de pruebas: una serie de MVPs ejecutados a través de una herramienta paperclip — un scaffold mínimo de harness usado para probar el comportamiento de handoff entre agentes, la fidelidad del payload de delegación y las primeras suposiciones de contexto antes de comprometer una carga de trabajo en producción. Esa fase de incepción es donde tomaron forma las primeras convenciones de AGENTS.md, donde los slots de handoff entre agentes fueron sometidos a prueba y donde aparecieron las primeras brechas estructurales. El diagnóstico descrito aquí se ejecutó sobre la flota después de que esta había graduado de esa fase temprana de harness.
Corrimos esto sobre nuestra propia flota interna de 3 agentes — Orchestrator, Developer, QA. El Orchestrator toma tickets de Jira, los evalúa, delega la implementación al Developer, rutea los PRs del Developer por QA, y o entrega a review humano o re-delega con feedback. Una anomalía de Leanmote venía disparándose hace semanas: el 17% de los PRs mergeados se iteraban post-review. Nadie tenía una lectura confiable de la causa raíz. La hipótesis era “el agente Developer no está suficientemente grounded; necesitamos mejores prompts.”
Cuatro rondas de entrevista, cuatro días, todo asíncrono vía Jira. ~70 disparos de trigger entre los tres agentes. La tasa del 17% se descompuso en cinco fallas estructurales compuestas — ninguna que tuneo de prompt hubiera resuelto:
- El payload de delegación del Orchestrator al Developer era referencial (file paths, doc references) pero le faltaban specs visuales y ejemplos negativos — un gap de citation engineering.
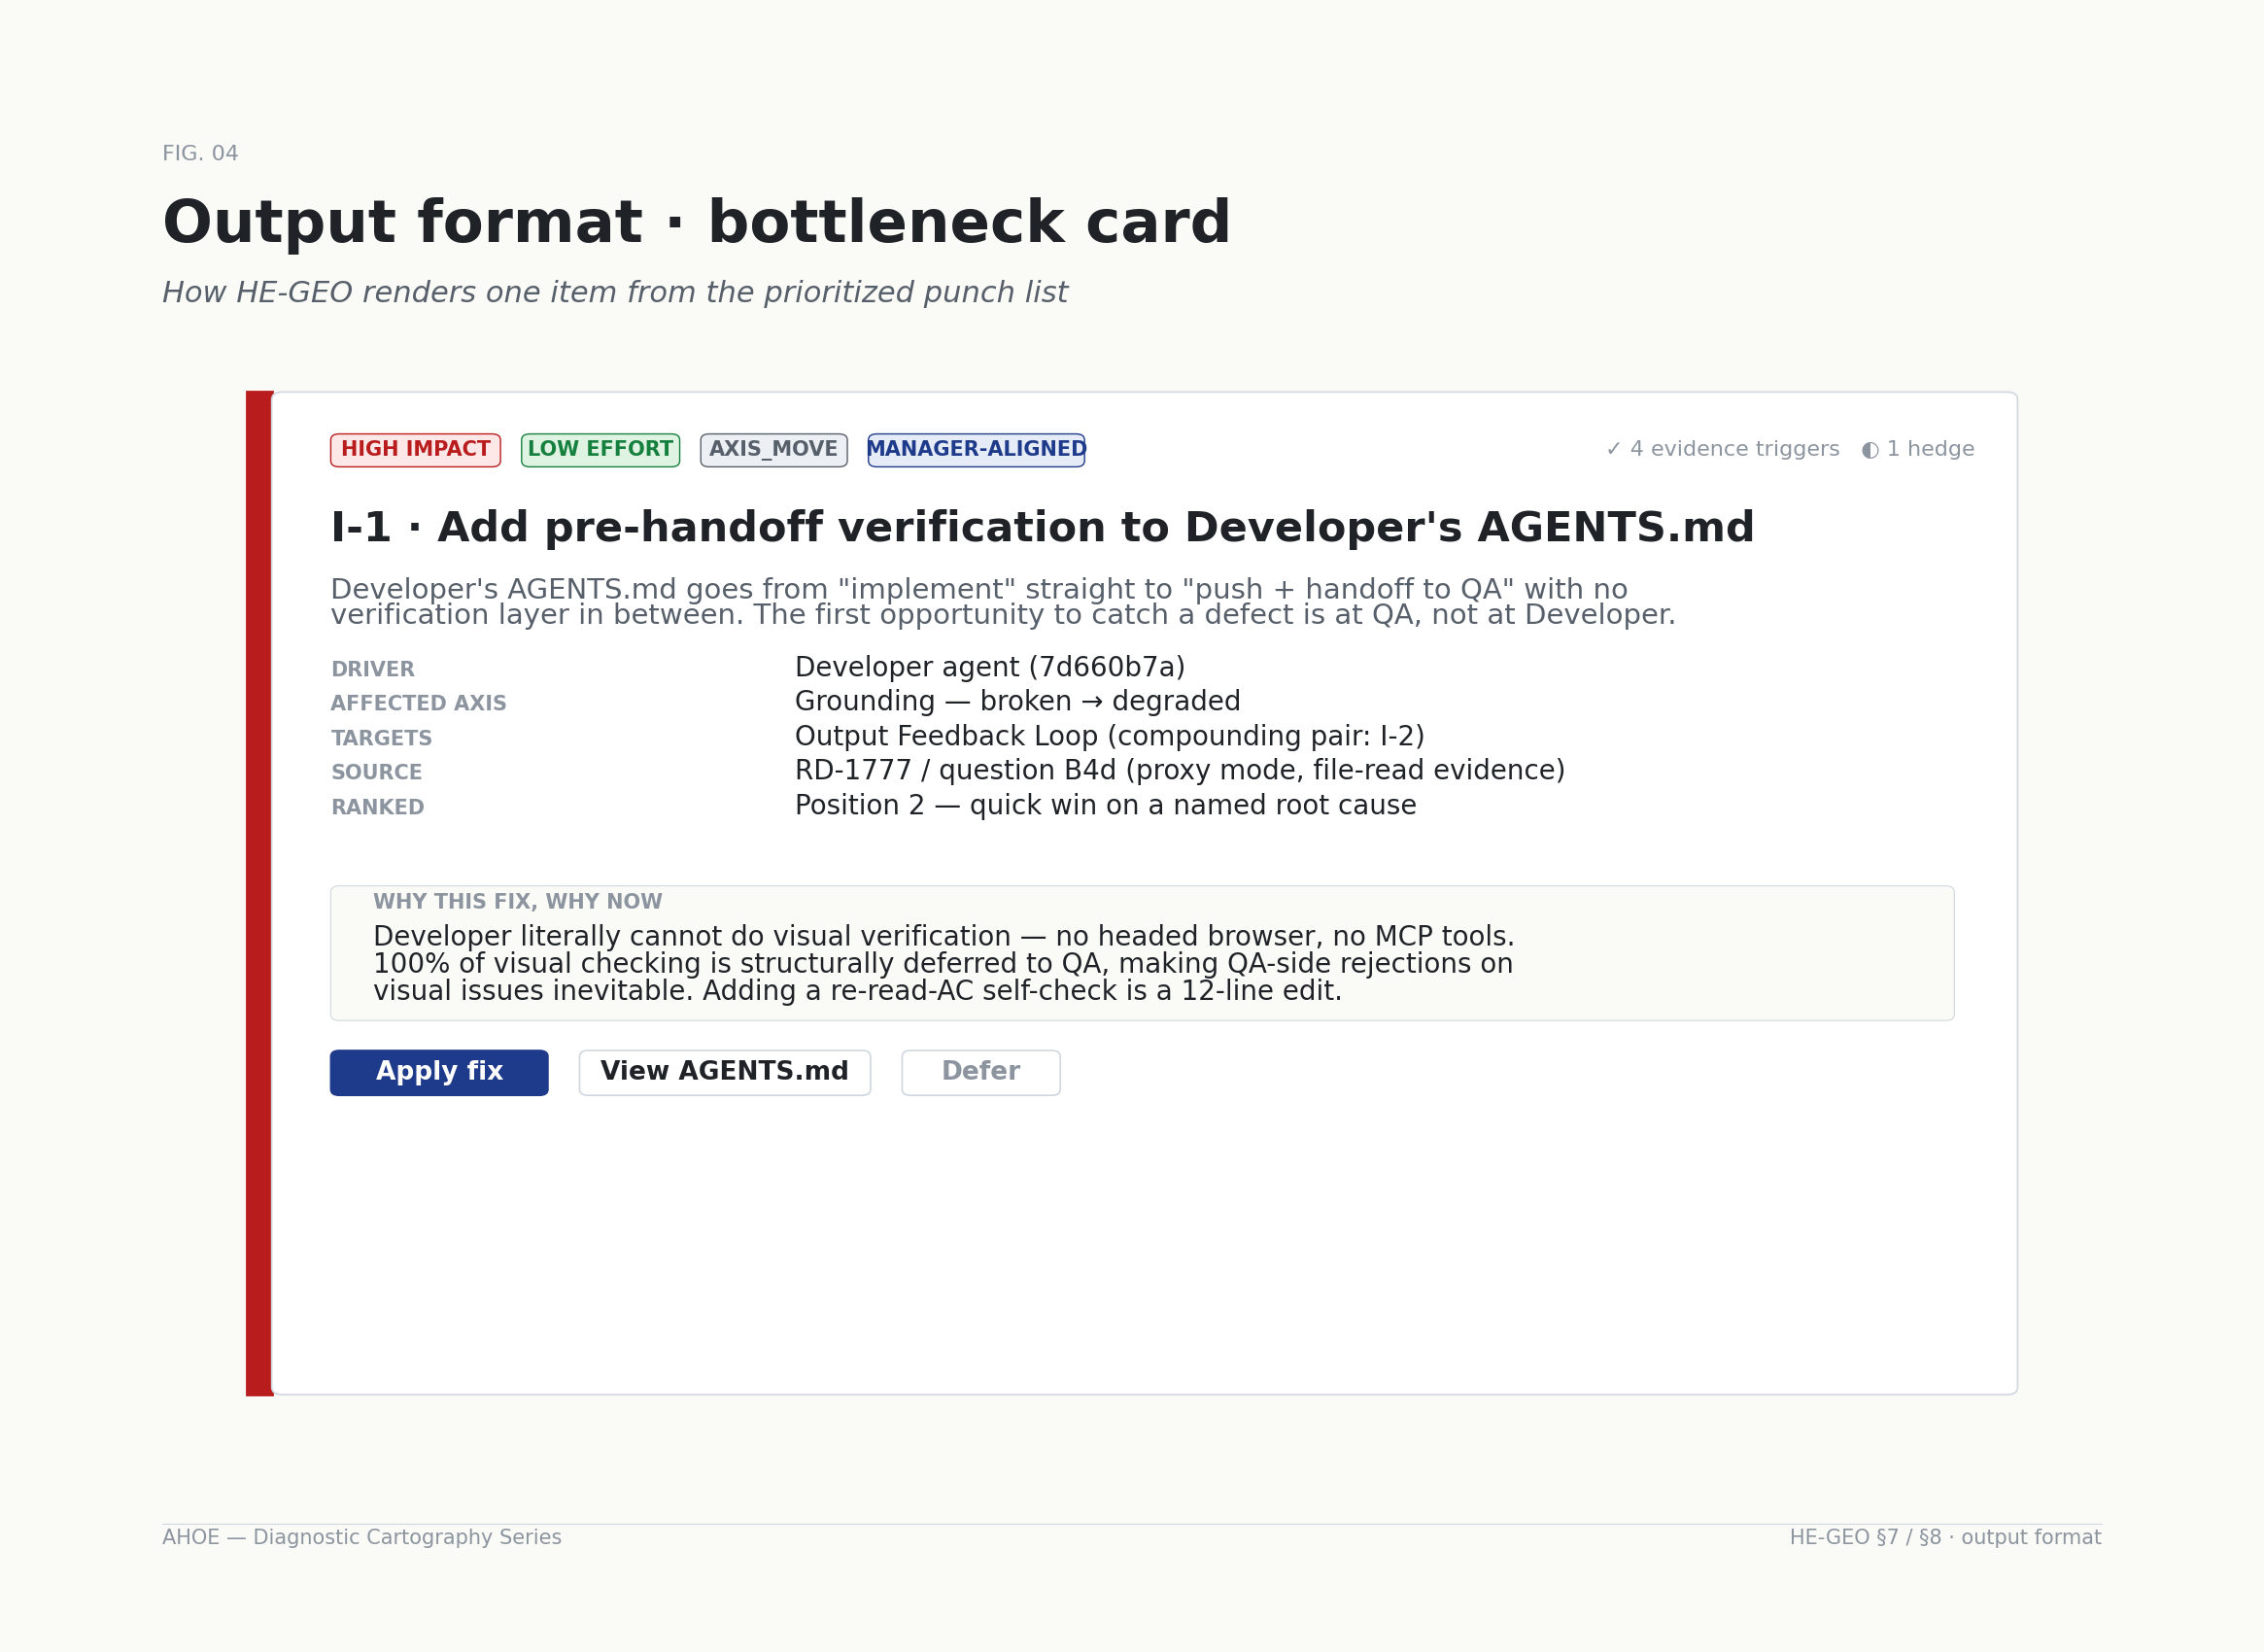
- El AGENTS.md del Developer no tenía paso de pre-handoff verification. De “implementar” directo a “push + handoff” — un gap de evidence-anchored content.
- El Developer literalmente no podía hacer verificación visual — sin headed browser, sin tools de MCP browser. La verificación estaba estructuralmente diferida a QA — un gap de tooling que hacía la fila anterior imposible de arreglar solo con prompts.
- La profundidad de verificación de QA era de una sola capa (acceptance criteria pass = approve). Caso canónico de falso-aprobado: un ticket donde QA verificó que aparecían tooltips con links “Learn more” pero no clickeó cada link para verificar el destino.
- Ningún agente tenía memoria cross-ticket. El mismo patrón de bug atrapado dos veces nunca llegaba a un anti-patterns.md — un gap de visibility-and-drift.
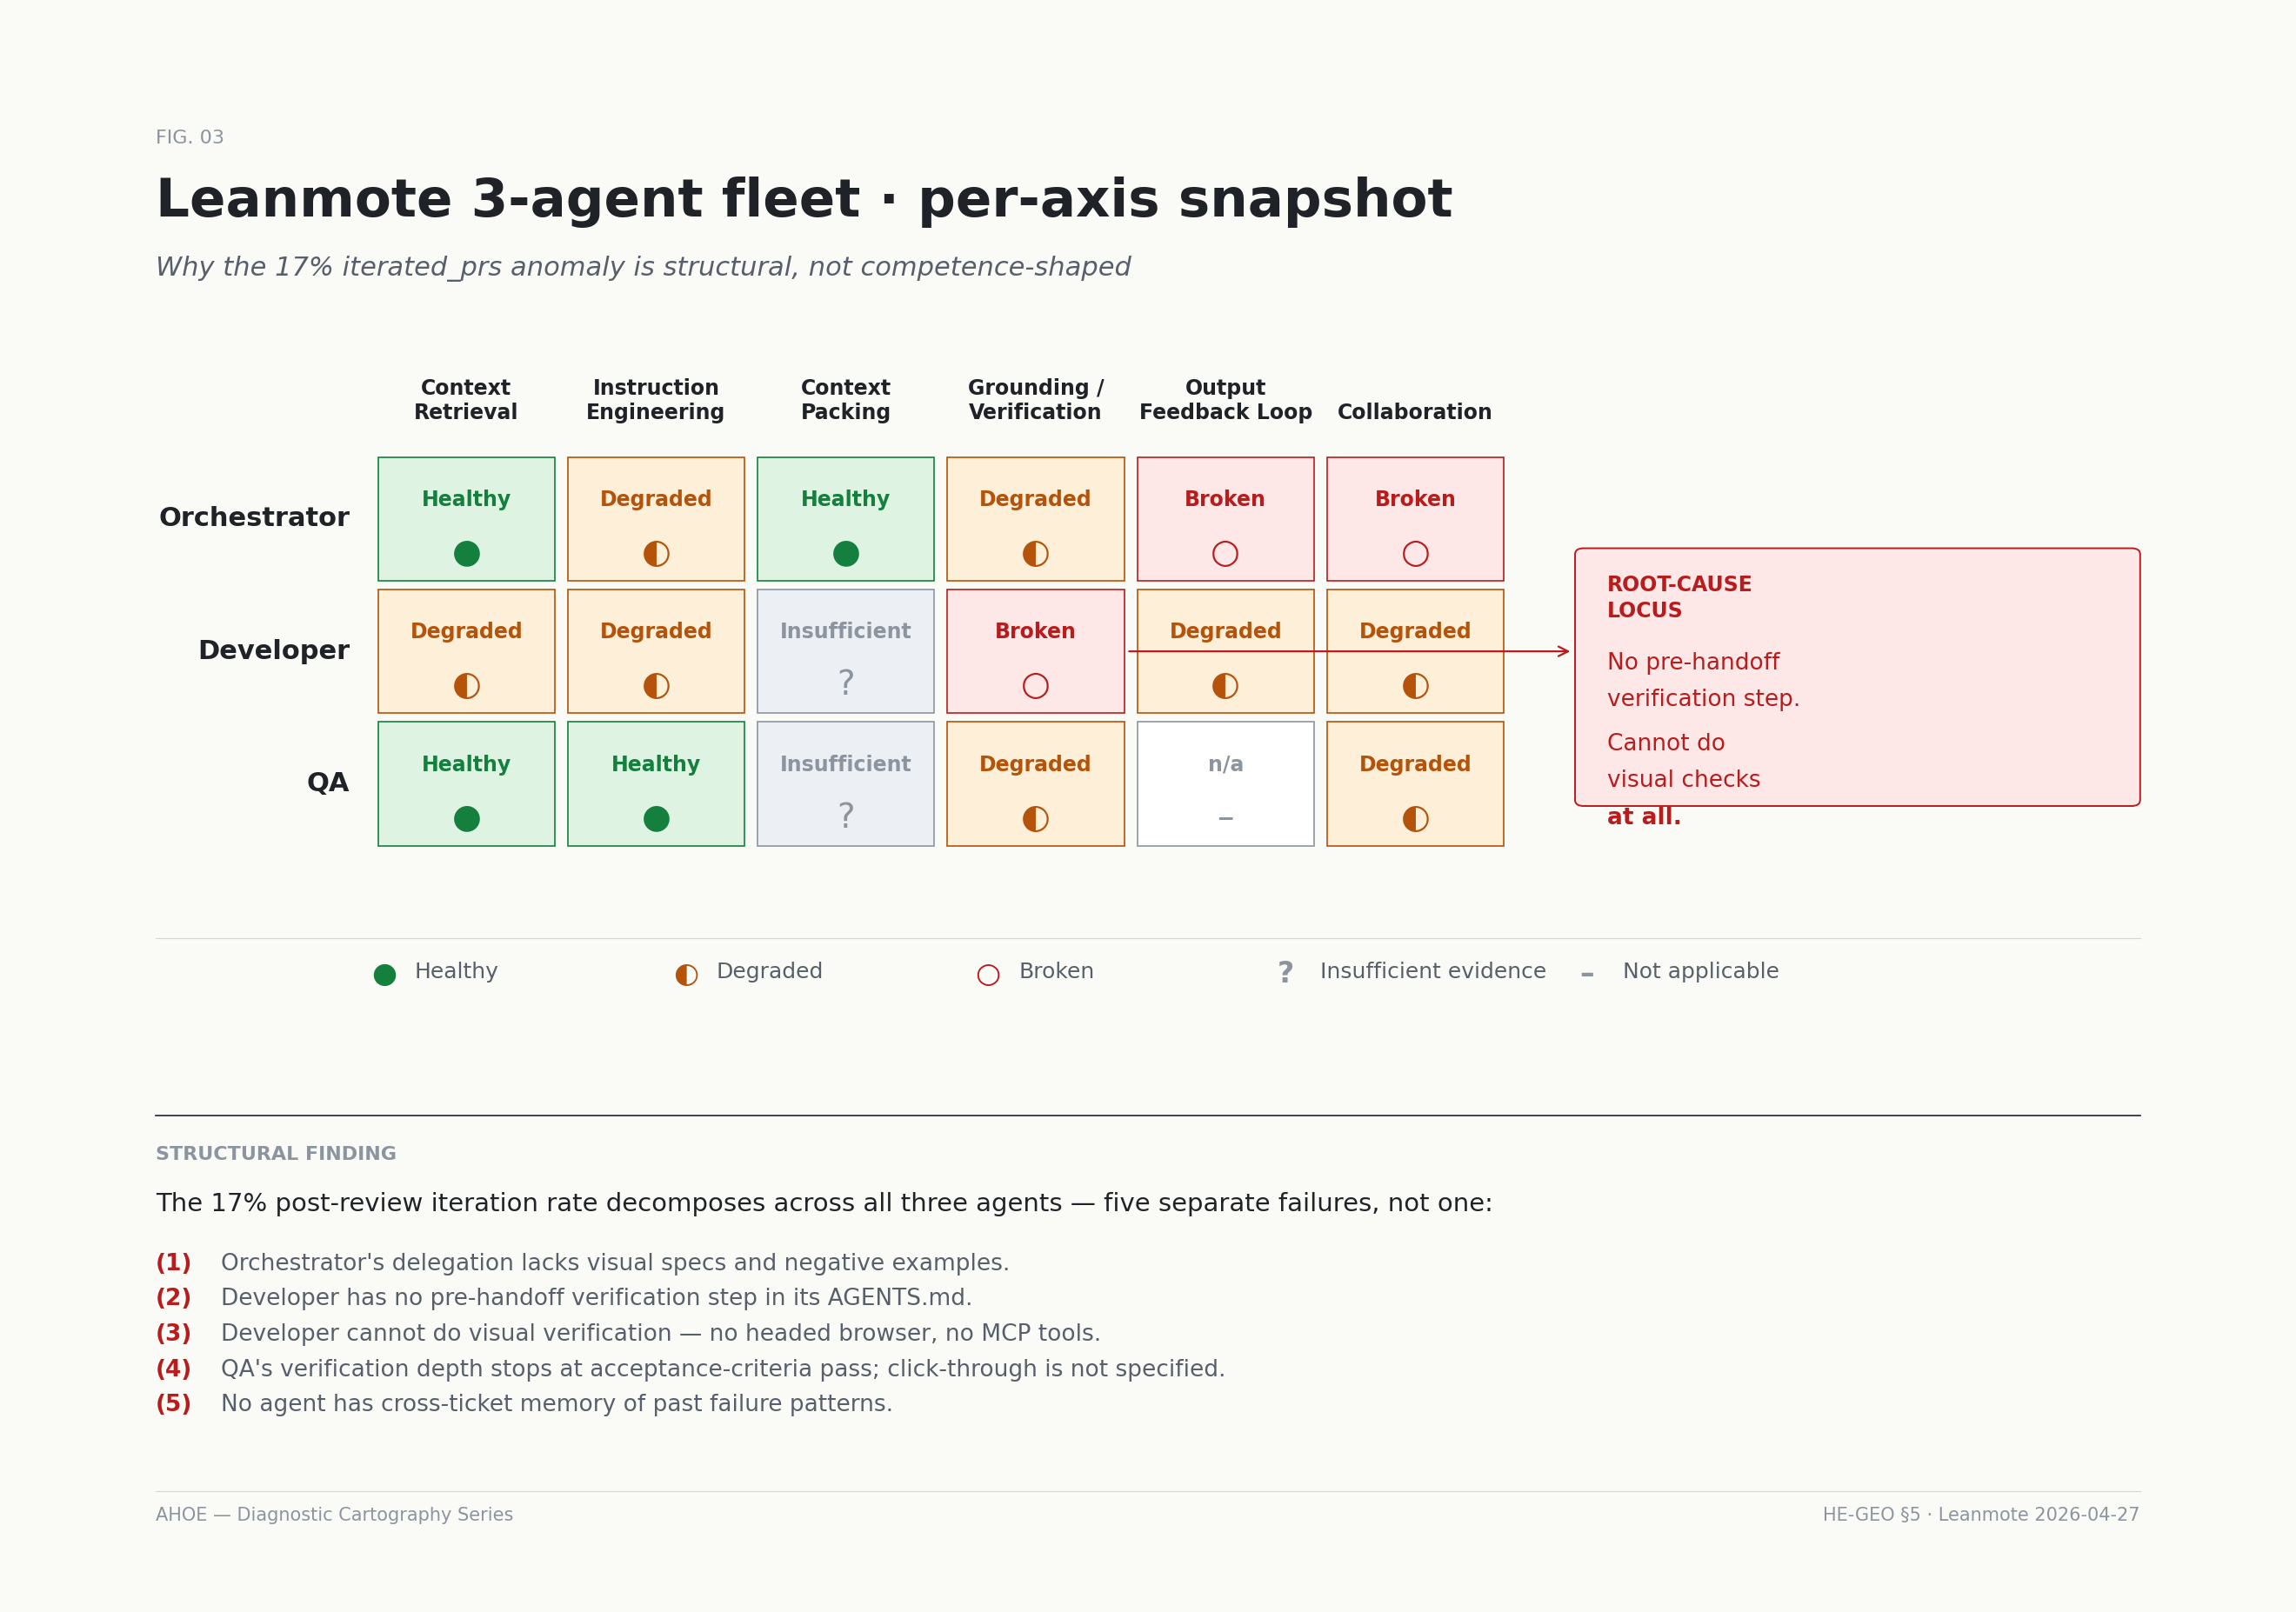
El 17% era el síntoma de una pipeline de verificación a la que le faltaban las capas 1–3, con un gap de profundidad en la capa 4 y ausencia de drift monitoring en la capa 5. Estructural, no de competencia. El diagnóstico también sacó algo que el equipo no había articulado: la flota puntuaba L1, limitada por Governance (sin cadencia de review sobre PRs del Orchestrator), Drift Detection (sin dashboard agregado de calidad) y Versioning (sin .git en el directorio del agente). Los agentes habían sido desplegados sobre un substrate que nadie había pensado como software — porque no parecía software, parecía prompts. La salida del diagnóstico es un punch list priorizado, rankeado Impact × Effort, con cada ítem renderizado como una tarjeta lista para decidir.
Por qué importa
Para CTOs operando agentes de IA en producción: las herramientas de optimización de harness que están apareciendo son reales y útiles. Pero contra qué señal optimizás está aguas arriba de qué optimizer usás. Si tu suite de evals es sintética o heredada de un benchmark que ya entró al training data, estás optimizando contra un proxy ruidoso. Armá evals internas a partir de production traces. Si operás sobre una plataforma de outcome telemetry, anclá la optimización del harness en esa capa de señal. La tabla de traducción es el framework para pensar qué cambiar; la outcome telemetry es la entrada que te dice qué fila importa más este trimestre.
La metodología ya existe, corre sobre señal de Leanmote más entrevistas estructuradas en Jira, sin tooling especializado. Lo que estamos construyendo encima es la plataforma — una herramienta que ingiere la outcome telemetry de tu equipo y los archivos de harness de tu agente, corre el diagnóstico sin un analista, genera el punch list y trabaja directo con tu agente vía el patrón proxy-mode para aplicar fixes que no requieren autorización humana. Si el problema de iterated-PRs / inconsistencia / retrabajo difícil de atribuir te suena familiar, abrimos una cohorte de early access — escribinos. El agente está bien. El harness es el trabajo. El framing que le traés al harness — y la señal de entrada en la que lo anclás — es el trabajo aguas arriba del trabajo.
Referencias
- Anthropic — Building effective agents
- Anthropic — How we built our multi-agent research system
- OpenAI — Introducing SWE-bench Verified
- Phil Schmid — Notas sobre agent harnesses, Google DeepMind
- Martin Fowler — Artículos sobre agentes de IA y práctica de ingeniería
- Atlan — Guía 2026 sobre plataformas de datos y agentes
- Hamel Husain — Cómo construir evals desde traces de producción
- Addy Osmani — Agentic Engine Optimization (AEO)
- HARBOR — Optimización Bayesiana restringida sobre la configuración del harness
- Meta-Harness — Coding agent en outer-loop para síntesis de harnesses
- SWE-Bench Pro — Benchmark aumentado con menor contaminación
- Gartner — Forecast: caída de búsqueda orgánica por motores generativos, 2026